Muitos aspectos têm me intrigado a respeito da formação de um profissional de tecnologia, especialmente quando percebo o quanto nós, que vivemos de software, sabemos pouco sobre a máquina que executa esse software.
Escrevemos código, subimos containers, discutimos arquitetura de microsserviços. Mas se alguém perguntar o que acontece entre você apertar uma tecla e a letra aparecer na tela, o silêncio costuma ser constrangedor. E olha, não é culpa sua: a indústria passou vinte anos construindo camadas de abstração justamente para que você não precisasse pensar nisso.
O problema é que abstração é como crédito bancário. Funciona lindamente até o dia em que a conta chega — e ela chega na forma de um deploy lento sem explicação, de um vazamento de memória, de um servidor que trava sob carga ou daquele bug que “só acontece em produção”.
Neste artigo eu quero abrir o capô. Vamos descer até o nível dos fios, subir de volta até o Sistema Operacional e entender, de forma didática, como essas duas coisas conversam. Sem fórmulas assustadoras, com bastante analogia e com um simulador no final para você ver tudo isso acontecendo.
Puxe uma cadeira. A aula vai começar.
Parte I — O Hardware: A Máquina Mais Burra e Mais Rápida do Mundo
A Verdade Desconfortável Sobre o Seu Computador
Vamos começar destruindo um mito.
O seu computador não é inteligente. Ele é, na verdade, absurdamente burro. Ele não sabe o que é uma foto, não sabe o que é uma música e definitivamente não sabe o que é um e-mail. Ele sabe fazer exatamente três coisas: somar números, comparar números e mover números de um lugar para outro.
Só isso.
A única vantagem dele é a velocidade. Ele faz essas três operações idiotas bilhões de vezes por segundo, sem reclamar, sem café e sem pedir aumento. Toda a “inteligência” que você vê na tela é consequência de repetir operações triviais numa velocidade que a nossa intuição não consegue acompanhar.
Guarde essa frase, porque ela é a chave de tudo:
Um computador é um laço muito curto, repetido muito rápido.
Os Três Personagens da Peça
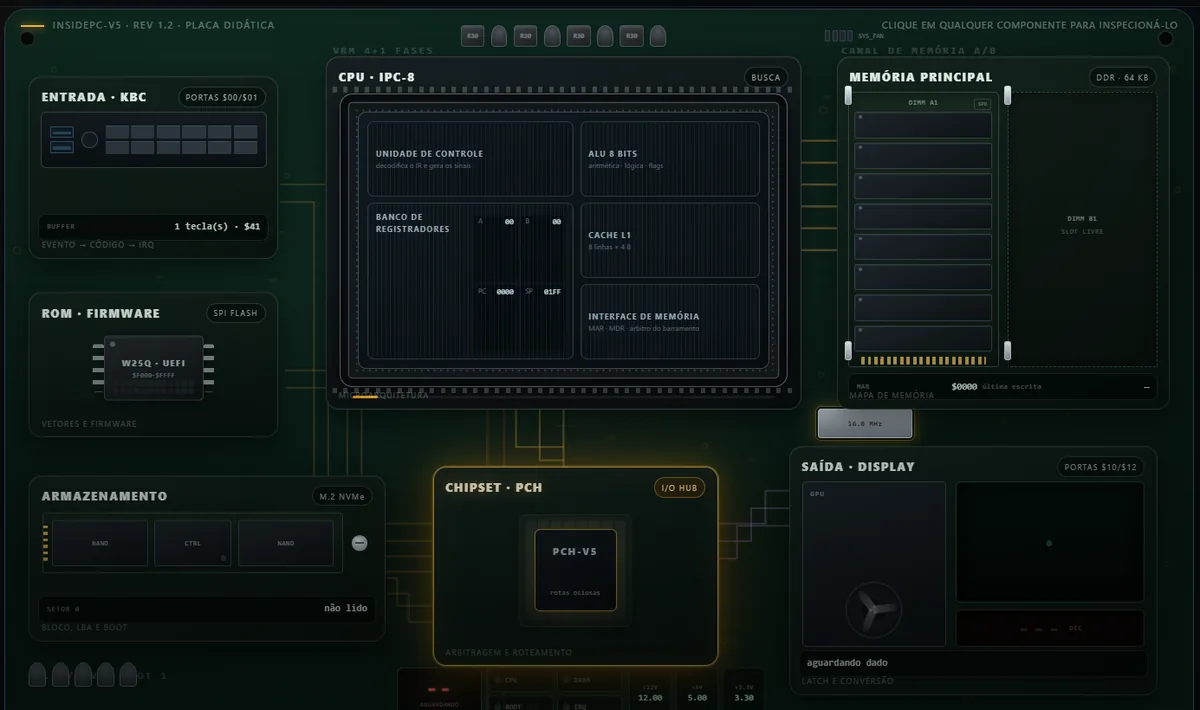
Toda máquina, do seu notebook ao servidor que hospeda este artigo, se organiza em três blocos:
CPU(Unidade Central de Processamento): onde as contas acontecem. É o cozinheiro.- Memória: onde ficam guardadas as instruções e os dados. É a bancada e a despensa.
E/S(Entrada e Saída): teclado, tela, disco, rede. É o salão do restaurante, de onde chegam os pedidos e para onde saem os pratos.
Talvez você já tenha pensado nisso: por que separar? Por que não colocar tudo junto?
Porque velocidade custa dinheiro. Memória rápida é cara e pequena; memória barata é lenta e grande. Toda a arquitetura de computadores, dos anos 40 até hoje, é basicamente uma sequência de gambiarras muito elegantes para esconder essa diferença de velocidade do programador. Vamos voltar a isso quando falarmos de cache.
Traduzindo o “Binariês”: Bits, Bytes e Hexadecimal
Antes de continuar, precisamos alinhar o vocabulário. Prometo ser rápido.
Bit: a menor unidade de informação. Dois estados possíveis: 0 ou 1. Fisicamente, é a presença ou ausência de tensão elétrica num fio. Nada mais místico que isso.Byte: oitobitsagrupados. Consegue representar 256 valores distintos (de 0 a 255). É a unidade prática de trabalho.- Hexadecimal: um sistema de numeração de base 16, escrito com
0-9eA-F. Existe puramente por conveniência humana: cada dígito hexadecimal equivale exatamente a quatrobits. Então umbytesempre cabe em dois dígitos ($00a$FF) e um endereço de 16bitssempre cabe em quatro ($0000a$FFFF).
Ninguém escreve %01000001 num documento técnico se pode escrever $41. E $41, por sinal, é a letra “A” na tabela ASCII.
Aqui vem o primeiro conceito realmente importante: o mesmo byte $41 pode ser a letra “A”, o número 65, uma cor, um pedaço de uma instrução ou um valor de brilho de um pixel. O byte não tem significado embutido. Quem dá significado é o contexto — ou seja, o programa.
É por isso que quando um arquivo “corrompe” e você abre num editor de texto, aparece aquele monte de símbolos estranhos. O programa está interpretando bytes de imagem como se fossem letras. Os bytes estão íntegros; o intérprete é que é o errado.
O Ciclo de Instrução: A Receita Que Nunca Termina
Agora, pensa comigo. Como a CPU faz alguma coisa útil?
Ela repete um ritual de quatro passos, para sempre, até você desligar a máquina:
| Etapa | Nome técnico | O que acontece |
|---|---|---|
| 1 | Busca (fetch) |
A CPU pega o endereço guardado no PC (Contador de Programa) e pede à memória o byte que está lá. |
| 2 | Decodificação (decode) |
Ela olha esse byte e descobre qual operação ele representa. |
| 3 | Execução (execute) |
Ela faz a conta, acessa a memória ou desvia o fluxo. |
| 4 | Escrita (writeback) |
O resultado volta para um registrador ou para a memória. |
E volta para o passo 1.
Pense num cozinheiro seguindo uma receita em que ele só consegue ler uma linha por vez e precisa marcar com o dedo em qual linha está. O dedo dele é o PC. A linha que ele acabou de ler é o IR (Registrador de Instrução). Se a receita diz “vá para a linha 7”, ele move o dedo. Se diz “repita até acabar a massa”, ele volta o dedo para trás.
Um detalhe que costuma quebrar a cabeça dos alunos: a CPU não sabe se um byte é instrução ou dado. Ela assume que aquilo que o PC está apontando é uma instrução. Se o seu programa desviar para o meio de uma tabela de dados, a CPU vai obedientemente tentar executar aqueles números como se fossem código. O resultado costuma ser espetacular — e no sentido ruim da palavra.
A Bancada do Cozinheiro: Registradores
Registradores são memórias minúsculas que ficam dentro do próprio chip, coladas na unidade de cálculo. São rapidíssimas e escassíssimas.
Os personagens clássicos:
PC(Program Counter): o dedo na receita. Aponta para a próxima instrução.IR(Instruction Register): a instrução que está sendo decodificada agora.MAR(Memory Address Register): o endereço que aCPUquer acessar.MDR(Memory Data Register): o dado que está indo ou vindo da memória.- Acumulador (
A): onde as contas acontecem e onde o resultado aparece. SP(Stack Pointer): o topo da pilha, que veremos em instantes.FLAGS: um punhado debitsque descrevem o último resultado.
Por que existem MAR e MDR? Porque o endereço precisa ficar estável nos fios enquanto o dado trafega. Sem esses dois registradores, seria como tentar ditar um número de telefone e escutar a resposta ao mesmo tempo, pelo mesmo bocal.
A ALU e as Flags: O Computador Fofocando Sobre o Próprio Resultado
A ALU (Unidade Lógica e Aritmética) é o circuito que soma, subtrai, compara e faz operações lógicas. Ela é combinacional: entra operando, sai resultado, sem memória do que aconteceu antes.
O que sobra depois de cada operação são as flags, quatro bits que funcionam como uma fofoca sobre o resultado:
| Flag | Nome | Vale 1 quando |
|---|---|---|
Z |
Zero | o resultado deu exatamente zero |
C |
Carry | “estourou” para além do último bit |
N |
Negativo | o bit mais significativo é 1 |
V |
Overflow | o resultado com sinal saiu da faixa válida |
E aqui está uma das revelações mais bonitas da computação: a CPU não tem instrução de “se”. Não existe IF no hardware.
O que existe é: a ALU faz uma subtração, isso liga ou desliga a flag Z, e uma instrução de desvio olha essa flag para decidir se muda o PC ou não. Todo if, while, for, switch, try/catch e match que você já escreveu na vida virou, lá embaixo, uma conta seguida de um desvio condicional.
Da mesma forma, não existe instrução de “repetir”. Existe um contador que decrementa e um desvio que volta o PC para trás enquanto a flag Z estiver desligada. Laço é ilusão de ótica.
Barramentos: A Rua de Mão Única do Interior
Barramento é um conjunto de fios compartilhados por vários dispositivos. São três:
- Barramento de endereços: unidirecional, sai da
CPU. Diz quem deve responder. - Barramento de dados: bidirecional. Carrega o
bytede fato. - Barramento de controle: sinais soltos que dizem o quê e quando (ler, escrever, endereço válido, interrupção).
Compartilhar fios é econômico, mas exige uma disciplina rígida: só um dispositivo pode “falar” por vez. Os outros precisam entrar em estado de alta impedância, que é o equivalente eletrônico de desconectar a boca do microfone. Se dois dispositivos falam ao mesmo tempo, você não tem uma discussão — você tem um curto-circuito.
É exatamente igual àquela rua estreita de cidade do interior onde só cabe um carro. Funciona muito bem, desde que exista uma convenção clara sobre quem passa primeiro.
Von Neumann vs Harvard: Uma Briga de Família
Existem duas maneiras de organizar memória e barramentos:
| Aspecto | Von Neumann | Harvard |
|---|---|---|
| Memória | uma só, para código e dados | separadas |
| Barramento | um só, compartilhado | dois independentes |
| Vantagem | simples, flexível, barato | busca instrução e dado ao mesmo tempo |
| Desvantagem | o barramento vira gargalo | mais fios, menos flexível |
| Onde vive | computadores de propósito geral | microcontroladores, DSPs |
O modelo Von Neumann tem uma consequência filosófica enorme: como código e dados moram no mesmo lugar, um programa pode tratar outro programa como dado. É isso que permite que exista compilador, carregador de programas e, no fim das contas, Sistema Operacional. Também é isso que permite que exista vírus, mas ninguém é perfeito.
O preço é o chamado gargalo de Von Neumann: a CPU nunca busca uma instrução e um dado simultaneamente. E é aqui que entra a próxima gambiarra elegante.
A Hierarquia de Memória: Onde a Física Cobra a Conta
Bem, deixa eu te dizer algo… a diferença de velocidade entre a CPU e a memória RAM é o maior problema não resolvido da computação moderna. E ele só piora a cada geração.
Números secos não comunicam bem essa distância, então vamos multiplicar tudo por um bilhão e converter para escala humana. Imagine que um ciclo de CPU equivale a um segundo da sua vida:
| Nível | Latência real | Na escala humana | Analogia |
|---|---|---|---|
| Registrador | ~0,3 ns | 1 segundo | pegar o que está na sua mão |
Cache L1 |
~1 ns | 3 segundos | pegar algo na sua mesa |
Cache L2 |
~4 ns | 12 segundos | levantar e pegar na estante |
Cache L3 |
~15 ns | 45 segundos | ir até a sala ao lado |
Memória RAM |
~100 ns | 5 minutos | descer e ir à padaria |
SSD NVMe |
~100 µs | 3 dias | pedir uma encomenda |
HD mecânico |
~10 ms | 10 meses | mandar buscar de navio |
| Rede (outro continente) | ~150 ms | 15 anos | mandar por carta e esperar |
Olhe essa tabela com atenção, porque ela explica quase tudo sobre otimização de desempenho.
Quando o seu processador precisa de um dado que está na RAM, do ponto de vista dele ele para de trabalhar por cinco minutos. Quando o dado está no disco, ele tira uma folga de três dias. Não é exagero retórico: é proporção real.
E é por isso que existe cache.
Cache: A Geladeira da Sua Casa
O conceito é simples e você já usa ele todos os dias sem saber.
Por que você tem geladeira em casa se existe supermercado? Porque ir ao supermercado toda vez que bate fome seria insano. Então você traz uma quantidade de comida e guarda por perto. A geladeira é pequena, cara por litro e limitada — mas está a três metros de você, e não a três quilômetros.
Cache é exatamente isso: uma memória pequena e cara, dentro do chip, que guarda cópias do que a CPU andou usando. E ela funciona por causa de dois comportamentos previsíveis de qualquer programa real, chamados de princípio da localidade:
- Localidade temporal: o que foi usado agora provavelmente será usado de novo em breve. (Você acabou de pegar a manteiga? Vai pegar de novo.)
- Localidade espacial: o que está perto do que foi usado provavelmente será usado também. (Pegou o pão? Vai querer a manteiga que está do lado.)
Por isso a cache nunca traz um byte sozinho. Ela traz um bloco inteiro de bytes vizinhos, apostando que você vai precisar deles. Quando o dado pedido já está lá, chamamos de acerto (hit). Quando não está, é uma falta (miss), e a CPU fica esperando a padaria.
Uma taxa de acerto de 95% pode parecer ótima, mas faça a conta: os 5% de faltas, custando 30 vezes mais caro cada, dominam completamente o tempo total. É por isso que percorrer uma matriz na ordem errada pode deixar seu código dez vezes mais lento sem que você tenha mudado uma linha da lógica. O algoritmo é o mesmo; a conversa com a memória é que virou um desastre.
Pipeline: A Lavanderia Que Todo Mundo Entende
Se cada instrução precisa passar por quatro etapas, e cada etapa usa uma parte diferente do circuito, deixar as outras três paradas é desperdício puro.
A solução é a mesma que qualquer pessoa com muita roupa suja já descobriu sozinha: enquanto a primeira leva está secando, a segunda já está lavando. Isso é pipeline.
Processadores modernos têm pipelines de 15 a 20 estágios. O ganho é enorme, mas surge um problema novo e delicioso: e quando aparece um desvio condicional? A CPU já tem cinco instruções adiantadas no cano — e ainda não sabe qual caminho vai tomar.
A solução é o preditor de desvio: a CPU literalmente chuta o resultado com base no histórico, e continua trabalhando com base no chute. Se acertar, lucro. Se errar, ela precisa jogar fora tudo o que adiantou e recomeçar — o que custa dezenas de ciclos.
Sim: o seu processador aposta. E acerta mais de 95% das vezes, o que é uma taxa que nenhum analista de mercado consegue.
(Curiosidade nada tranquilizadora: as falhas Spectre e Meltdown, de 2018, exploraram justamente os rastros deixados por essas execuções especulativas que “não deveriam ter acontecido”. A CPU desfez o trabalho, mas esqueceu de apagar as pegadas na cache.)
O Momento Mais Solitário da Máquina: O Boot
Agora um problema de galinha e ovo. Quando você aperta o botão, a RAM está vazia. Não há sistema operacional carregado. Não há nada.
Como é que essa máquina sai do lugar?
A resposta é linda de tão pragmática: existe um endereço fixo, gravado no silício, que a CPU lê ao acordar. É o vetor de reset. Ele aponta para a ROM, onde mora o firmware (BIOS/UEFI), que é a única coisa que já está lá antes de tudo.
E aí a sequência é:
- A fonte estabiliza e envia o sinal
Power Good. - A
CPUsai doresete lê o vetor.PCrecebe o endereço dofirmware. - O
firmwareexecuta oPOST(Power-On Self-Test), publicando códigos de diagnóstico enquanto testa memória e dispositivos. - Ele encontra o dispositivo de
boote copia o primeiro setor para a memória. - Ele desvia para o código recém-carregado e sai de cena.
- Esse código carrega o Sistema Operacional de verdade.
O termo em inglês para isso é bootstrap — da expressão “puxar-se para cima pelos próprios cadarços”. É fisicamente impossível e conceitualmente perfeito.
Detalhe divertido: nos PCs compatíveis, o endereço onde o setor de boot é carregado é $7C00. Esse número foi escolhido em 1981 por razões que fizeram sentido naquele momento e nunca mais mudou. Você tem, dentro do seu computador de 2026, um endereço fixado por uma decisão tomada quando o disquete ainda era novidade. Compatibilidade retroativa é a força mais poderosa do universo.
Parte II — O Sistema Operacional: O Síndico do Prédio
Por Que Isso Precisa Existir?
Chegamos ao ponto onde o hardware termina e o software começa a mandar.
Imagine um prédio de apartamentos sem síndico, sem regras e sem porteiro. Qualquer morador pode entrar em qualquer apartamento, usar a vaga de quem quiser, cortar a água do vizinho ou ocupar o elevador para sempre. Seria o caos absoluto.
O Sistema Operacional é o síndico. Ele não é o prédio, não é o morador, e sozinho ele não produz nada de útil. Mas sem ele, cada programa teria que negociar diretamente com o hardware e confiar na boa vontade dos outros — o que, convenhamos, já sabemos como termina.
O SO tem quatro trabalhos:
- Abstrair o
hardware(você abre “um arquivo”, não “o setor 4.812 do disco”). - Compartilhar recursos entre programas que não se conhecem.
- Proteger cada programa dos outros e o sistema de todos.
- Arbitrar conflitos quando todo mundo quer a mesma coisa ao mesmo tempo.
Kernel Mode e User Mode: A Portaria do Prédio
Como o SO impõe autoridade se ele é apenas mais um programa?
Com apoio do hardware. O processador tem níveis de privilégio, chamados de anéis (rings). O kernel roda no Ring 0, onde tudo é permitido. Os seus programas rodam no Ring 3, onde várias instruções simplesmente não funcionam — a CPU recusa a executar.
É a diferença entre a chave-mestra do síndico e a chave do seu apartamento. Não é uma questão de etiqueta: é a fechadura que é diferente.
Quando um programa em Ring 3 tenta fazer algo privilegiado, a CPU gera uma exceção e entrega o controle ao kernel, que decide o que fazer. Normalmente ele encerra o programa. No Linux isso aparece como Segmentation fault; no Windows, como aquela janelinha de “o programa parou de funcionar”.
E aqui está a parte importante: isso não é um bug. Isso é o sistema de proteção funcionando exatamente como projetado. O Segmentation fault não é a falha; é o alarme.
Chamadas de Sistema: O Guichê de Atendimento
Se o seu programa não pode falar com o hardware, como ele grava um arquivo?
Ele faz uma chamada de sistema (syscall): coloca o pedido num formato padronizado e executa uma instrução especial que transfere o controle ao kernel de forma controlada, num ponto de entrada previamente definido.
É o guichê da repartição pública. Você não entra atrás do balcão e mexe no arquivo você mesmo. Você preenche o formulário, entrega, e um funcionário autorizado faz o serviço. Chato? É. Burocrático? Bastante. Mas é o que impede que qualquer um saia arrancando pastas do armário.
Quando você escreve um inocente print("olá") em Python, a cadeia é aproximadamente esta:
print("olá")                 →  função da linguagem
  sys.stdout.write()         →  biblioteca padrão
    fwrite()                 →  libc
      syscall write(1, ...)  →  transição para Ring 0
        driver do terminal   →  kernel
          hardware           →  fios de verdade
Seis camadas para escrever quatro letras. E ainda assim isso acontece em microssegundos.
Processos e Threads: Inquilinos e Moradores
- Processo: um programa em execução, com seu próprio espaço de memória isolado. É o apartamento.
- Thread: uma linha de execução dentro de um processo. São os moradores do mesmo apartamento.
A distinção prática é toda sobre isolamento:
| Processos | Threads | |
|---|---|---|
| Memória | isolada, cada um a sua | compartilhada dentro do processo |
| Custo de criação | alto | baixo |
| Comunicação | complicada (precisa do SO) |
trivial (mesma memória) |
| Se um travar | os outros seguem vivos | costuma levar todos juntos |
| Analogia | apartamentos separados | pessoas dividindo o mesmo apê |
Threads compartilharem memória é ao mesmo tempo a vantagem e a maldição. Duas threads alterando a mesma variável ao mesmo tempo produzem a condição de corrida (race condition), o tipo de bug que só aparece em produção, às três da manhã, e nunca quando você está olhando.
É a clássica situação de dois moradores decidindo, cada um por conta própria, que precisa comprar leite. Você volta para casa com quatro litros e a certeza de que fez tudo certo.
Escalonamento: A Ilusão do “Ao Mesmo Tempo”
Aqui está uma coisa que surpreende muita gente: um núcleo de processador executa uma coisa por vez. Só uma. Sempre.
Aquela sensação de rodar navegador, música, IDE e vinte abas simultaneamente é uma mentira muito bem contada. O que acontece é que o escalonador dá a cada processo uma fatia de tempo minúscula (alguns milissegundos), tira o processador dele e passa para o próximo. Milhares de vezes por segundo.
É um garçom cuidando de vinte mesas. Ele não atende ninguém “ao mesmo tempo” — ele circula tão rápido que todo mundo tem a impressão de estar sendo bem atendido. Se você tem oito núcleos, são oito garçons. Ainda muito menos que o número de mesas.
O ato de guardar o estado de um processo e carregar o do próximo se chama troca de contexto (context switch), e ela não é grátis: registradores salvos, cache esfriando, TLB invalidada. Um sistema que troca de contexto demais gasta mais tempo trocando do que trabalhando — é o garçom que fica tão ocupado andando entre as mesas que não consegue anotar nenhum pedido.
Os critérios de escolha variam conforme o objetivo:
| Estratégia | Prioriza | Onde é usada |
|---|---|---|
FIFO |
ordem de chegada | sistemas simples, filas de lote |
Round-Robin |
justiça, todos ganham um pedaço | sistemas interativos |
| Por prioridade | tarefas críticas primeiro | tempo real, servidores |
CFS (Linux) |
justiça proporcional ponderada | desktops e servidores Linux |
Memória Virtual: A Maior Mentira Bem-Intencionada da Computação
Este é, na minha opinião, o conceito mais elegante de todo o Sistema Operacional.
Todo programa que você executa acredita, sinceramente, que possui a memória inteira só para si, começando no endereço zero. Todos eles acreditam nisso. Ao mesmo tempo. E nenhum descobre a verdade.
O truque é uma peça de hardware chamada MMU (Unidade de Gerenciamento de Memória). Toda vez que um programa acessa um endereço, a MMU traduz aquele endereço virtual para um endereço físico real, consultando uma tabela mantida pelo SO.
A analogia certa aqui é a caixa postal. Duas empresas podem ter, cada uma, a “sala 101” no cartão de visitas. Os correios sabem que uma fica na Avenida Paulista e a outra em Copacabana. Os endereços colidem no papel, mas nunca na realidade física.
Isso resolve, de uma tacada só, três problemas grandes:
- Isolamento: um processo não consegue nem expressar um endereço de outro. Não é que ele seja proibido — é que aquele endereço, para ele, significa outra coisa.
- Fragmentação: a memória física pode estar toda picotada, mas o programa enxerga um espaço contínuo e bonito.
- Ilusão de abundância: o programa pode usar mais memória do que existe fisicamente.
A tradução acontece em blocos chamados páginas (tipicamente 4 KB). E como consultar a tabela de páginas a cada acesso seria lentíssimo, existe uma cache só para traduções recentes: a TLB (Translation Lookaside Buffer). É cache de cache. Nesta altura do artigo você já não deveria estar surpreso.
Swap e Thrashing: Quando a Mentira Cobra o Preço
E quando a memória física acaba de verdade?
O SO pega páginas que ninguém usa há um tempo e escreve no disco, liberando espaço. Isso é o swap (ou arquivo de paginação). Quando o programa pedir aquela página de volta, ocorre uma falta de página (page fault) e o SO traz de volta do disco.
Funciona bem — desde que aconteça pouco. Volte na tabela de latências: o disco é milhares de vezes mais lento que a RAM.
Quando a memória fica realmente apertada, o sistema entra em thrashing: ele passa a gastar mais tempo movendo páginas entre RAM e disco do que executando programas. O sintoma é inconfundível: a máquina fica lentíssima, o HD trabalha sem parar, mas o uso de CPU está baixo. Ela está ocupadíssima — carregando caixas de um lado para o outro sem abrir nenhuma.
É a pessoa que tem uma mesa pequena demais e passa o expediente guardando e tirando papel da gaveta. Nenhum trabalho é feito, e ainda assim ninguém parou um minuto.
Sistemas de Arquivos: Do Setor ao “Documentos”
Fisicamente, um disco é uma sequência gigantesca de blocos numerados. Nada mais. Não existem pastas, não existem nomes, não existe “Área de Trabalho”.
O sistema de arquivos é a estrutura de dados que cria essa ilusão organizada: ele mantém um índice que diz “o arquivo relatorio.pdf ocupa os blocos 4.812, 4.813 e 9.001”.
Isso explica dois mistérios do dia a dia:
Por que apagar é instantâneo, mas copiar demora? Porque apagar não apaga nada. O SO apenas remove a entrada do índice e marca os blocos como livres. Os dados continuam lá, intactos, até alguém escrever por cima. É por isso que existe recuperação de dados — e é por isso que “formatar” antes de vender um HD não é suficiente.
Por que existe fragmentação? Porque arquivos crescem, encolhem e são apagados. Com o tempo, os espaços livres viram buracos espalhados, e um arquivo novo acaba dividido entre eles. Num HD mecânico isso é péssimo, pois a cabeça precisa se deslocar fisicamente. Num SSD, é irrelevante — não há peça se movendo, e o acesso a qualquer bloco custa igual. É por isso que você não deve desfragmentar um SSD: além de inútil, você gasta ciclos de escrita da memória flash à toa.
Interrupções: O Garçom Que Não Fica Te Encarando
Como o SO descobre que você apertou uma tecla?
Existem duas abordagens:
Polling: o programa fica perguntando, num laço infinito, “chegou tecla? chegou tecla? chegou tecla?”. Funciona, mas queima 100% do processador para não fazer absolutamente nada. É o garçom que fica parado ao lado da sua mesa, encarando você, esperando que peça mais alguma coisa. Constrangedor e caro.
Interrupção: o dispositivo avisa a CPU quando algo acontece. A CPU termina a instrução atual, guarda o contexto na pilha, desvia para uma rotina de tratamento (ISR), resolve o assunto e volta exatamente para onde estava — sem que o programa interrompido perceba nada.
É o garçom que cuida das outras mesas e vem quando você levanta a mão. Toda a eficiência dos sistemas modernos depende desse modelo. Teclado, mouse, rede, disco, temporizador: tudo funciona por interrupção.
Aliás, o próprio escalonador depende disso. Um temporizador dispara uma interrupção a cada poucos milissegundos, o que devolve o controle ao kernel mesmo que o programa em execução não queira colaborar. Sem esse temporizador, um while(true) mal escrito congelaria a máquina inteira — que era exatamente o que acontecia nos sistemas cooperativos antigos, para quem tem idade de lembrar.
Deadlock: O Cruzamento Que Ninguém Cede
Quando vários processos disputam recursos, surge um problema clássico: o impasse (deadlock).
O processo A travou o arquivo 1 e quer o arquivo 2. O processo B travou o arquivo 2 e quer o arquivo 1. Nenhum solta o que tem. Nenhum consegue o que quer. Ambos esperam para sempre, muito educadamente.
É aquele cruzamento onde quatro carros chegam juntos, cada um querendo virar, e todos avançaram meio metro a mais do que deviam. Ninguém consegue passar, e ninguém consegue dar ré.
Um impasse exige quatro condições simultâneas — exclusão mútua, posse com espera, ausência de preempção e espera circular — e quebrar qualquer uma delas resolve. A mais usada é impor uma ordem global de aquisição: se todos os processos sempre pedirem os recursos na mesma sequência, a espera circular se torna impossível. É o equivalente a instalar um semáforo.
Kernel Monolítico vs Microkernel
Última briga arquitetural do dia:
| Monolítico (Linux) | Microkernel (QNX, Minix) |
Híbrido (Windows NT, macOS) |
|
|---|---|---|---|
O que roda em Ring 0 |
quase tudo, inclusive drivers |
o mínimo absoluto | o essencial e alguns serviços |
| Desempenho | alto (tudo é chamada direta) | menor (muita troca de mensagens) | intermediário |
| Robustez | um driver ruim derruba o sistema |
um driver ruim morre sozinho |
intermediária |
| Analogia | uma casa grande sem paredes internas | um condomínio de casinhas | casa com algumas paredes |
O Linux é monolítico, mas modular: os drivers são carregados e descarregados em tempo de execução, o que dá boa parte da flexibilidade sem o custo de desempenho. É um monólito com portas — o que, no fim das contas, foi a decisão de engenharia que venceu o debate na prática.
(Se esse tema te pegou, eu destrinchei a arquitetura do Kernel NT versus a modularidade do Linux, incluindo Ring 0, WSL 2 e Live Patching, no artigo sobre Windows 11 vs Linux.)
Parte III — Chega de Teoria: Vamos Ver a Máquina Funcionando
Aqui está o problema de tudo o que você acabou de ler: são palavras sobre coisas invisíveis.
Você pode decorar “busca, decodifica, executa” para a prova e nunca ter visto um byte sair de um lugar e chegar em outro. E acredite: existe uma diferença enorme entre saber a definição e ter visto acontecer.
Foi exatamente por isso que eu construí o InsidePC, um laboratório visual de arquitetura de computadores que roda direto no navegador:
🔬 Acessar o simulador InsidePC
E faço questão de destacar o que o diferencia da maioria dos materiais didáticos por aí: ele não anima um diagrama — ele executa um programa de verdade.
Existe uma CPU completa por baixo, a IPC-8, com conjunto de 44 instruções, montador assembly de duas passagens, cache L1 real de mapeamento direto, pilha, interrupções vetorizadas e firmware gravado em ROM. Cada brilho que você vê na placa corresponde a um ciclo de barramento que realmente aconteceu. Se você editar o programa e trocar um opcode, o comportamento muda — porque não existe animação pré-gravada em lugar nenhum.
São oito laboratórios guiados, que seguem exatamente a sequência desta aula:
| Lab | Tema | O que você vai finalmente ver |
|---|---|---|
| 01 | Teclado → RAM → CPU → Display |
um byte atravessando a máquina inteira sem mudar |
| 02 | Soma na ALU |
as flags nascendo do resultado |
| 03 | Boot completo | POST, teste de RAM, leitura do setor 0 e entrega de controle |
| 04 | Cache L1 |
a mesma leitura custando 4 ciclos e depois 1 |
| 05 | Interrupção de teclado | contexto empilhado, ISR, IRET e o programa seguindo alheio |
| 06 | Laço e desvio | por que “repetir” não existe no hardware |
| 07 | Sub-rotina e pilha | multiplicação por somas, com CALL/RET |
| 08 | Editor livre | o seu próprio assembly, montado e executado na hora |
Você pode avançar microoperação por microoperação (aqueles passos T1, T2, T3 que os livros mostram em tabela), colocar pontos de parada, inspecionar a memória em hexadecimal e acompanhar um analisador lógico desenhando CLK, ALE, RD, WR e IRQ a partir do traço real da execução.
Há dois modos de leitura: o básico, que narra em português claro o que acabou de acontecer, e o de engenharia, que mostra o mesmo evento em notação RTL, com sinais e endereços. São duas leituras do mesmo fato, não dois simuladores.
Minha sugestão sincera: leia esta aula até aqui, abra o LAB 03 e assista a máquina se levantar pelos próprios cadarços. É um daqueles momentos em que o conceito para de ser abstrato de uma vez por todas.
Conclusão: Qual Camada Você Domina?
No fim das contas, tudo o que vimos aqui se resume a uma cadeia de decisões muito humanas tomadas diante de limitações muito físicas.
A memória é lenta, então inventamos cache. O barramento é um só, então inventamos pipeline. Programas não são confiáveis, então inventamos anéis de privilégio. A memória física é escassa, então inventamos memória virtual. Um núcleo faz uma coisa por vez, então inventamos escalonamento.
Nenhuma dessas soluções é mágica. Todas são compromissos: você ganha em um lugar e paga em outro. E o profissional que entende onde está pagando é exatamente aquele que consegue diagnosticar o problema que os outros classificam como “está lento, deve ser a internet”.
Não é preciso ser projetista de processador. Mas quando você souber que uma falta de cache custa o equivalente a uma ida à padaria, que uma troca de contexto joga fora o trabalho de aquecimento da cache e que o seu Segmentation fault é a MMU fazendo exatamente o trabalho dela, você para de programar no escuro.
A arquitetura da máquina que executa o seu código é tão importante quanto o código que você escreve.
Então fica a pergunta difícil: você conhece mesmo a máquina em que trabalha todos os dias, ou apenas confia que ela vai funcionar?
Referências e Leituras Recomendadas
Separei abaixo o material que sustenta os conceitos deste artigo, dividido entre o que temos aqui no portal, as fontes primárias e a bibliografia clássica.
Recomendações do Projeto Plataforma
- InsidePC — Simulador de Arquitetura de Computadores — O laboratório visual descrito na Parte III.
CPUIPC-8completa, montadorassembly,cache, interrupções ebootreal, rodando no navegador, sem instalação e sem depender de internet. - Windows 11 vs Linux: Uma Análise Técnica Profunda Sobre Arquitetura, Atualizações e a Sua Carreira — O aprofundamento natural da Parte II:
Kernel NThíbrido,Ring 0, modularidade do Linux,WSL 2eLive Patching. - Guia de Resolução: SSD Não Reconhecido na BIOS ou Instalação Dell — Toda a teoria de
firmware,POSTe dispositivo debootaplicada num problema real de bancada. - Acelere sua carreira em TI: O método definitivo para dominar tecnologias — Como transformar fundamentos como estes em diferencial competitivo de verdade.
Documentação Oficial e Fontes Primárias
- The Linux Kernel Archives (
kernel.org) — Documentação oficial sobre gerenciamento de memória, escalonadorCFS,driverse chamadas de sistema. - Microsoft Learn — Arquitetura do Windows — Referência sobre o modelo de
kernelhíbridoNT, níveis de privilégio e virtualização de segurança. - Intel® 64 and IA-32 Architectures Software Developer Manuals — A fonte definitiva sobre conjunto de instruções, anéis de privilégio, paginação e
TLB. - Arm Developer Documentation — Contraponto essencial: uma arquitetura
RISCmoderna com decisões de projeto bem diferentes das da Intel. - UEFI Specifications — UEFI Forum — O padrão que substituiu a
BIOStradicional no processo de inicialização.
Bibliografia Clássica
- PATTERSON, David A.; HENNESSY, John L. — Organização e Projeto de Computadores: A Interface Hardware/Software. A referência definitiva sobre ciclo de instrução,
pipeline, hierarquia de memória e avaliação de desempenho. - TANENBAUM, Andrew S. — Organização Estruturada de Computadores e Sistemas Operacionais Modernos. Insuperável na noção de níveis de abstração e nos fundamentos de processos, escalonamento e memória virtual.
- STALLINGS, William — Arquitetura e Organização de Computadores. Cobertura minuciosa de barramentos,
E/Se interrupções. - PETZOLD, Charles — Code: The Hidden Language of Computer Hardware and Software. Constrói um computador inteiro partindo do relé, em linguagem acessível. Leitura obrigatória para quem quer entender de verdade.
- NISAN, Noam; SCHOCKEN, Shimon — The Elements of Computing Systems (projeto
Nand2Tetris). O percurso completo de porta lógica a sistema operacional, construindo tudo com as próprias mãos. - ARPACI-DUSSEAU, Remzi e Andrea — Operating Systems: Three Easy Pieces. Excelente, moderno e disponível gratuitamente pelos autores.
FAQ Estratégico (Perguntas Frequentes)
1. Eu preciso mesmo saber disso se trabalho com frontend ou desenvolvimento web?
Precisa, e talvez mais do que quem trabalha com sistemas. Renderização travando, animação engasgando, aplicação consumindo memória sem parar, aba do navegador derrubando a máquina: todos esses problemas são, no fundo, problemas de cache, de alocação de memória e de escalonamento. A diferença é que quem conhece os fundamentos diagnostica em minutos o que os outros passam dias tentando adivinhar.
2. Qual a diferença prática entre um processador de mais GHz e um de mais núcleos?
Mais GHz significa executar uma sequência de instruções mais rápido — ótimo para tarefas que não podem ser divididas, como a maior parte do código do dia a dia. Mais núcleos significa executar várias sequências ao mesmo tempo — ótimo para compilação, renderização, banco de dados e servidores web. Se o seu problema é intrinsecamente sequencial, dobrar o número de núcleos não resolve absolutamente nada. Nove mulheres não fazem um bebê em um mês.
3. Por que meu computador com 16 GB de RAM fica lento se o Gerenciador de Tarefas mostra memória livre?
Provavelmente o gargalo não é quantidade, mas latência e localidade. Muitos programas pequenos disputando cache, muita troca de contexto ou acesso desordenado à memória produzem lentidão mesmo com RAM sobrando. Vale checar também se o swap está sendo usado apesar da memória aparentemente livre — em algumas configurações o sistema pagina cedo demais.
4. Aprender assembly ainda faz sentido em 2026?
Faz — não para escrever sistemas nele, mas para entender o que o compilador faz com o seu código. Uma semana com assembly didático ensina mais sobre desempenho, pilha e memória do que meses de tutoriais de otimização. É por isso que o LAB 08 do InsidePC existe: assembly como ferramenta de compreensão, não como linguagem de produção.
5. Máquina virtual e container são a mesma coisa?
Não, e a diferença está exatamente no que discutimos. A máquina virtual emula hardware completo e roda um kernel próprio em cima de um hypervisor — isolamento forte, custo alto. O container compartilha o kernel do host e apenas isola a visão de processos, rede e sistema de arquivos usando recursos do próprio SO (namespaces e cgroups) — isolamento mais leve, custo baixo. Prédios separados versus apartamentos no mesmo prédio.
6. Por que o SSD acabou com o conselho de desfragmentar o disco?
Porque desfragmentar existia para reduzir o deslocamento físico da cabeça de leitura de um HD mecânico. No SSD não existe peça em movimento e todo bloco custa o mesmo tempo para acessar. Desfragmentar um SSD não traz ganho nenhum e ainda consome ciclos de escrita da memória flash, que são finitos. O que o SSD usa no lugar é o comando TRIM, que avisa qual bloco não é mais necessário.
Sobre o autor: Clark Maltempi desenvolve sistemas sob medida, automações corporativas e dashboards com Python, Flask e infraestrutura em containers. Escreve sobre tecnologia, carreira e engenharia de software no Projeto Plataforma.
© 2026 Projeto Plataforma — projetoplataforma.com.br