Você faz uma pergunta aparentemente simples para um assistente interno da empresa:
“Qual é o prazo de cancelamento do contrato Enterprise?”
Três segundos depois, ele responde, cita a política comercial correta e ainda aponta a página do documento onde encontrou a informação.
Na tela, aconteceu uma conversa.
Por baixo dela, pode ter acontecido uma pequena operação logística: uma API recebeu a pergunta, outro componente transformou texto em números, um mecanismo de busca procurou trechos parecidos, filtros verificaram quais documentos aquele usuário podia acessar, um modelo recebeu apenas parte desse material e, finalmente, uma resposta voltou pela rede.
E isso é só o caminho da pergunta. Horas antes, quando alguém enviou o PDF com a política comercial, outros processos provavelmente extraíram o texto, quebraram o documento em pedaços, geraram embeddings e atualizaram um índice. O usuário nunca viu essa etapa. Nem deveria.
É aqui que workers, Redis e RAG começam a fazer sentido juntos.
Não porque sejam três nomes da moda que precisam aparecer no mesmo diagrama, mas porque resolvem problemas diferentes de uma mesma aplicação: quem executa trabalhos demorados, onde estados e mensagens circulam, e como um modelo encontra conhecimento que não está confiavelmente armazenado em seus próprios parâmetros.
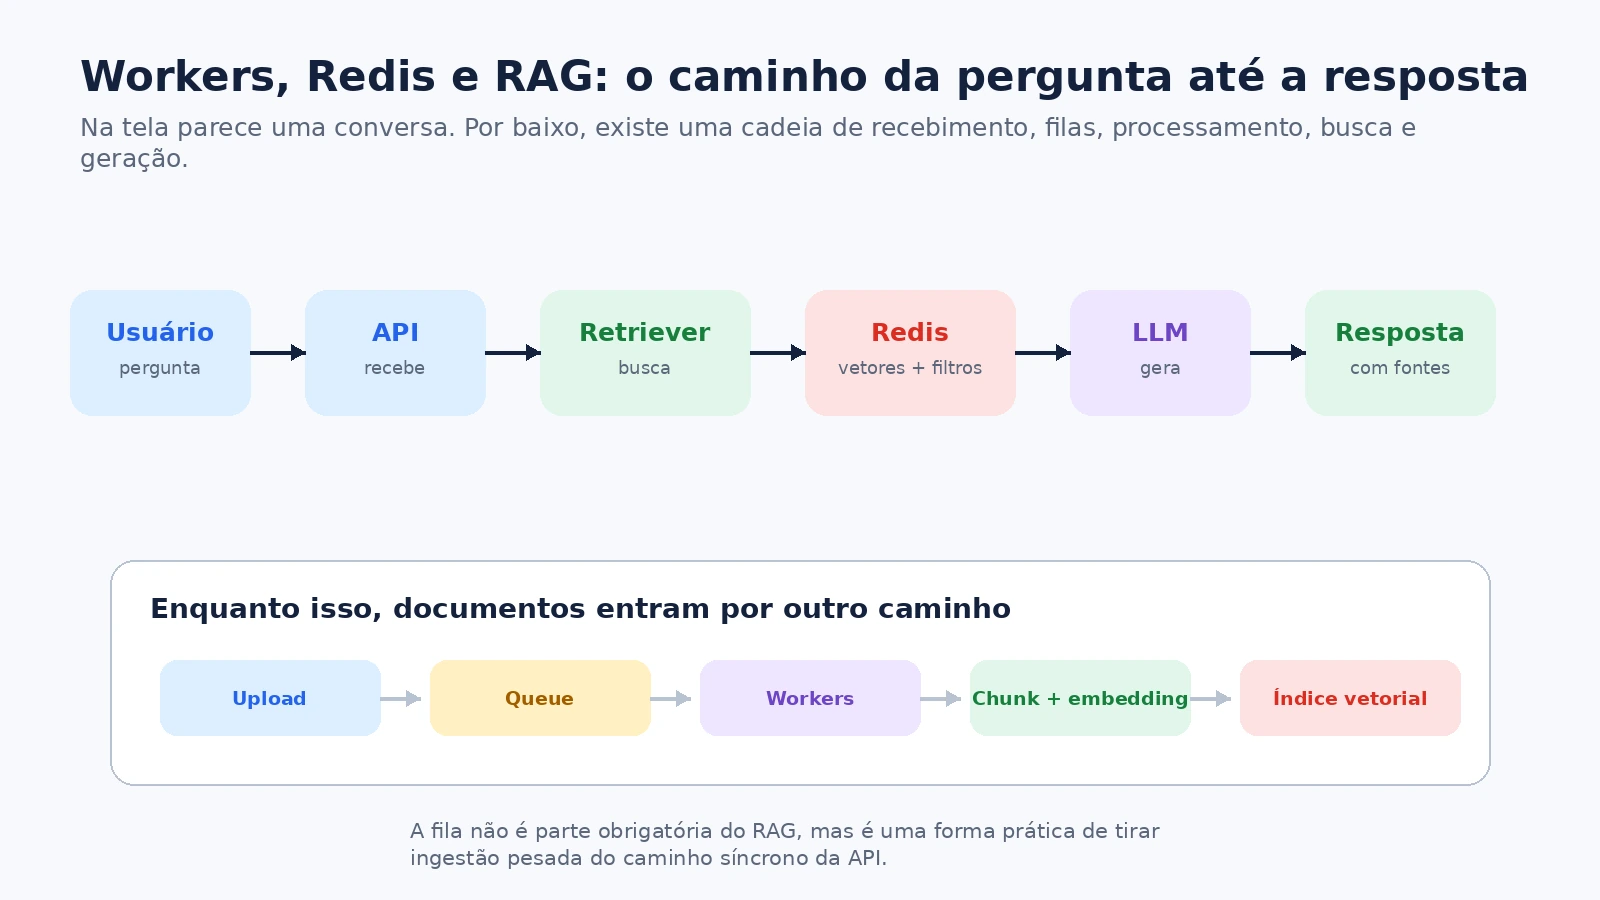
A proposta deste artigo é abrir essa arquitetura por camadas. Primeiro vamos entender por que um worker existe. Depois veremos por que Redis é muito mais do que “um cache rápido”. Só então entraremos em RAG, embeddings, busca vetorial e HNSW.
A ordem importa. RAG em produção começa muito antes do LLM.
O problema aparece quando a request precisa fazer trabalho demais
Vamos começar sem inteligência artificial.
Imagine uma API que recebe um PDF de 200 páginas. Depois do upload, ela precisa extrair texto, identificar títulos, remover lixo do parser, talvez executar OCR, dividir o conteúdo em trechos, chamar um modelo de embedding dezenas ou centenas de vezes e finalmente atualizar um índice de busca.
Uma implementação ingênua pode fazer tudo dentro da mesma requisição HTTP:
cliente
  │
  ▼
POST /documentos
  │
  ├─ salva arquivo
  ├─ extrai texto
  ├─ divide conteúdo
  ├─ gera embeddings
  ├─ indexa
  │
  ▼
200 OK
Com um documento pequeno, em um ambiente de testes, funciona. É exatamente assim que arquiteturas ruins costumam começar: funcionando.
O problema aparece quando o processamento leva 40 segundos, o serviço de embeddings oscila, três usuários enviam arquivos ao mesmo tempo ou um proxy encerra a conexão por timeout.
Nesse momento, a requisição HTTP virou uma sala de espera. A aplicação não está apenas recebendo um pedido; ela está tentando manter o cliente conectado enquanto coordena várias operações que possuem tempos e falhas independentes.
Pense em um restaurante onde o garçom recebe seu pedido e, em vez de entregar a comanda para a cozinha, fica parado na frente do fogão até o prato terminar. Enquanto isso, ninguém recebe as outras mesas.
A analogia é exagerada, mas o problema técnico é real: receber trabalho e executar trabalho não precisam acontecer no mesmo processo nem no mesmo intervalo de tempo.
É daí que nasce a fila.
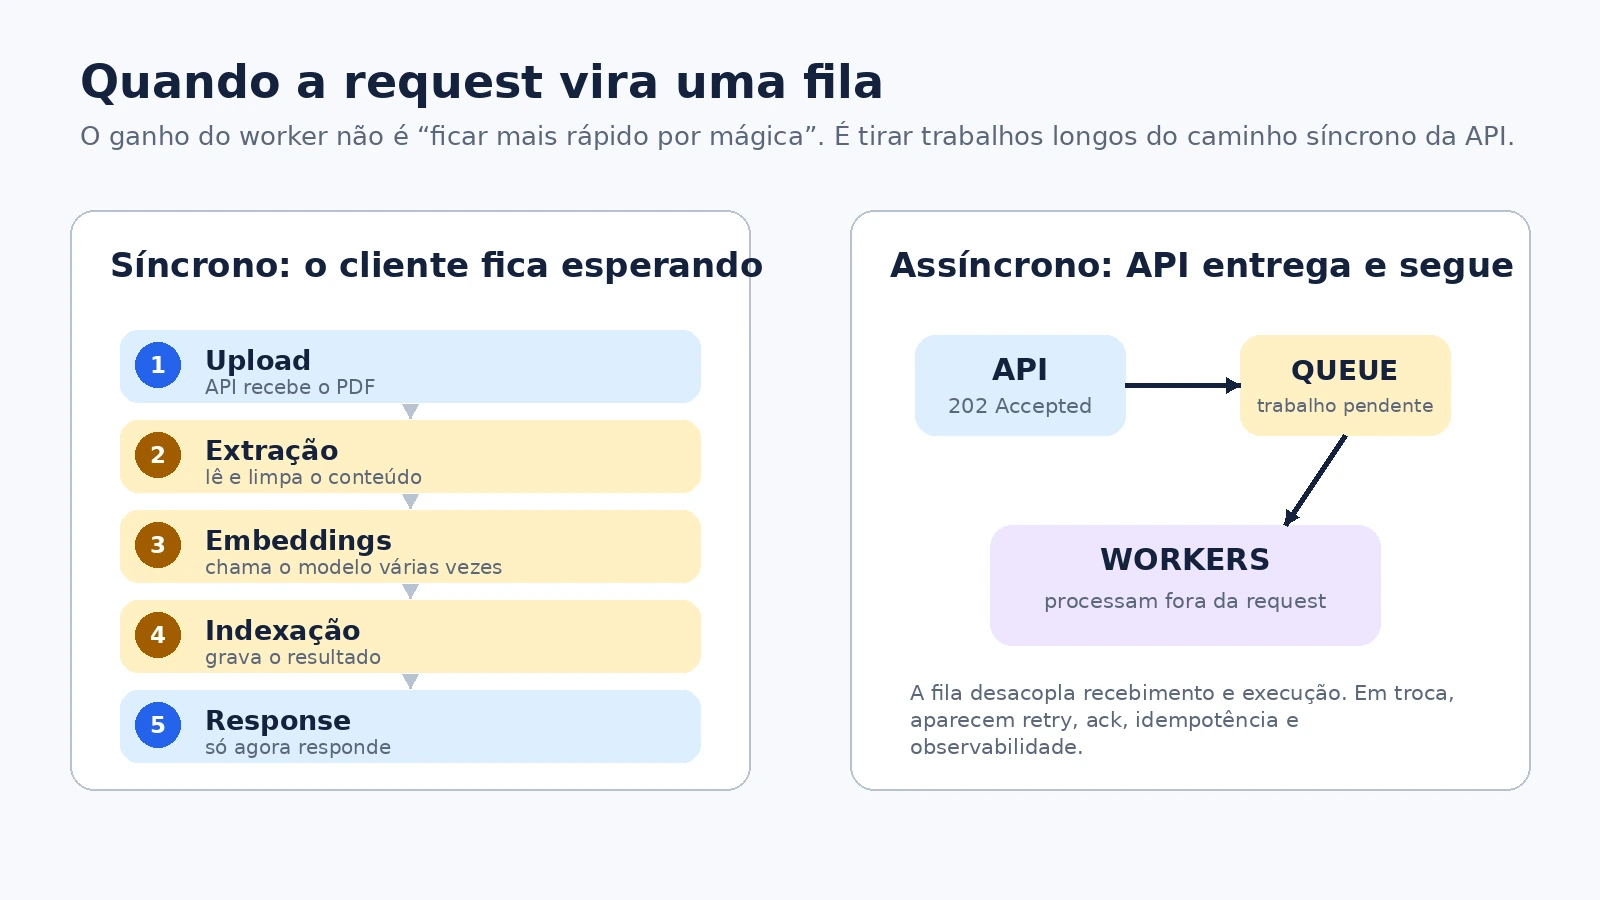
Uma API pode aceitar o documento, registrar que existe um processamento pendente e devolver algo como:
HTTP/1.1 202 Accepted
Content-Type: application/json

{
  "document_id": 8472,
  "status": "processing"
}
202 Accepted não significa “terminei”. Significa algo mais honesto: recebi e aceitei o trabalho, mas ele ainda será processado.
Agora precisamos de alguém do outro lado da fila.
Worker não é “uma thread com outro nome”
A palavra worker aparece em servidores web, bibliotecas de filas, navegadores, plataformas de CI/CD e sistemas distribuídos. Por isso ela parece descrever uma tecnologia específica, quando na verdade descreve um papel.
Um worker é uma unidade de execução dedicada a consumir e processar trabalho. Dependendo da implementação, ele pode ser um processo, uma thread, um container, um pod ou uma combinação dessas coisas.
Em uma arquitetura com Celery, por exemplo, a aplicação publica uma mensagem de tarefa em um broker. Um worker conectado ao mesmo broker recebe essa mensagem e encontra a função correspondente pelo nome da tarefa. A própria documentação do Celery descreve a tarefa como algo que possui dois lados: quando chamada, envia uma mensagem; quando recebida pelo worker, executa o trabalho associado.
Um exemplo reduzido:
from celery import Celery

app = Celery(
    "documentos",
    broker="redis://redis:6379/0",
    backend="redis://redis:6379/1",
)

@app.task
def processar_documento(documento_id: int):
    texto = extrair_texto(documento_id)
    chunks = dividir_em_chunks(texto)
    gerar_e_indexar_embeddings(documento_id, chunks)
A API não precisa executar a função diretamente:
processar_documento.delay(8472)
Esse .delay() parece inocente. Mas conceitualmente aconteceu uma mudança enorme.
Antes:
chamada de função → execução → retorno
Agora:
publicação de mensagem → broker → worker → execução → resultado/estado
A função deixou de ser apenas uma chamada local e passou a participar de um sistema distribuído.
E sistemas distribuídos têm memória longa para humilhar certezas locais.
Celery, Redis e worker: três papéis que parecem a mesma coisa no primeiro contato
Antes de avançar, vale desfazer uma confusão que costuma acompanhar quem implementa isso pela primeira vez.
Celery não é o Redis. Redis não é o worker. E o worker não é a fila.
Eles cooperam, mas cada um resolve uma parte diferente do problema.
| Peça | O que faz | Pergunta que responde |
|---|---|---|
| aplicação/API | produz o trabalho | “o que precisa ser feito?” |
| Celery | transforma trabalho em tarefa distribuída, publica, roteia e controla execução | “como esse trabalho circula?” |
Redis como broker |
mantém mensagens de tarefas disponíveis para consumo | “onde a tarefa espera?” |
| Celery Worker | consome mensagens e coordena a execução | “quem vai buscar o trabalho?” |
| pool do worker | executa as tarefas de fato | “quantas tarefas consigo executar em paralelo?” |
result backend |
opcionalmente guarda estado e resultado | “terminou? falhou? qual foi o retorno?” |
A documentação do Celery define o sistema justamente dessa forma: aplicações enviam mensagens por meio de um broker, e processos worker monitoram as filas para receber unidades de trabalho.
Pense em uma transportadora. Celery define a etiqueta, o fluxo e as regras da entrega. Redis pode funcionar como o centro de distribuição onde os pacotes aguardam. O worker é o veículo que retira um pacote e o leva para execução.
A analogia ajuda, mas existe um detalhe técnico ainda mais interessante: quando usamos Redis como broker, a “fila do Celery” não é uma entidade mágica que existe dentro do Redis com uma placa escrita Celery Queue.
Ela é construída pelo transporte do Celery sobre estruturas normais do Redis.
O que realmente acontece quando executamos .delay()
Considere novamente:
processar_documento.delay(8472)
Quem está começando pode imaginar que .delay() abre um processo em segundo plano e chama a função depois.
Não é isso.
A chamada cria uma mensagem de tarefa. Conceitualmente, ela carrega informações como:
nome da tarefa: tasks.processar_documento
id da tarefa:    9d8f...
argumentos:      [8472]
opções:          fila, retry, ETA, headers...
Essa mensagem é serializada e enviada ao broker.
Com o transporte Redis atual do Celery/Kombu, a fila é representada por uma list do Redis. Publicar uma tarefa envolve colocar a mensagem nessa estrutura; os consumidores aguardam trabalho usando operações bloqueantes. A documentação descreve esse caminho com LPUSH para publicação e BRPOP para consumo. Pub/Sub não é usado para transportar as tarefas normais do Celery.
O fluxo deixa de parecer mágico:
API
 │
 │ processar_documento.delay(8472)
 ▼
Celery produtor
 │
 │ serializa a mensagem
 ▼
Redis / lista da fila
 │
 │ worker aguarda e retira uma mensagem
 ▼
Celery Worker
 │
 │ entrega a tarefa a um slot de execução
 ▼
processo/thread do pool
 │
 │ executa processar_documento(8472)
 ▼
ack / resultado / próximo trabalho
Isso também explica uma boa prática: não envie o PDF inteiro dentro da mensagem da fila.
Salve o arquivo antes em um storage, banco ou serviço de objetos e envie apenas uma referência pequena:
processar_documento.delay(document_id=8472)
Em vez de:
processar_documento.delay(pdf_em_base64=arquivo_enorme)
A documentação do Celery caracteriza Redis como um bom transporte para mensagens pequenas e alerta que mensagens grandes podem congestionar o sistema. A fila deve transportar a comanda da cozinha, não o freezer inteiro.
O worker por dentro: um processo que normalmente coordena outros processos
Existe outra simplificação perigosa:
“Tenho quatro workers, então processo quatro tarefas.”
Talvez. Mas é preciso saber o que estamos chamando de worker.
Quando executamos:
celery -A celery_app worker --loglevel=INFO --concurrency=4
iniciamos uma instância de worker com concorrência quatro.
No modelo padrão atual do Celery, prefork, existe um processo principal que mantém a comunicação com o broker e coordena um pool de processos filhos. Esses processos filhos são os slots que executam as tarefas.
De forma simplificada:
Celery Worker
│
├── processo principal
│   ├── conexão com broker
│   ├── recebe mensagens
│   └── distribui trabalho
│
└── pool de execução
    ├── processo 1 → tarefa A
    ├── processo 2 → tarefa B
    ├── processo 3 → tarefa C
    └── processo 4 → tarefa D
Portanto, --concurrency=4 não significa iniciar quatro servidores Celery completos. Significa oferecer quatro slots concorrentes dentro daquela instância, de acordo com o pool escolhido.
O Celery suporta outros modelos, como threads, eventlet, gevent e solo. O prefork continua sendo a opção padrão e recomendada para muitos workloads; eventlet e gevent podem favorecer cargas fortemente orientadas a I/O, mas mudam o modelo de concorrência e não suportam exatamente o mesmo conjunto de recursos.
Para quem está começando, a escolha mais saudável é menos empolgante: comece com prefork, meça o workload e só troque o pool quando existir um motivo técnico claro.
Um parser pesado pode consumir CPU. Uma chamada para API de embeddings passa boa parte do tempo esperando rede. OCR pode combinar CPU, memória e I/O. “Tarefa de IA” não descreve o comportamento computacional dela.
É o comportamento que deve orientar a concorrência.
Implementando Celery + Redis sem esconder a arquitetura
Vamos montar a menor estrutura capaz de demonstrar o fluxo real.
Primeiro, instalamos o Celery com o suporte ao Redis:
pip install -U "celery[redis]"
Para desenvolvimento local, podemos subir Redis rapidamente:
docker run --name redis-rag -p 6379:6379 redis:8-alpine
Agora criamos celery_app.py:
from celery import Celery

app = Celery(
    "rag",
    broker="redis://localhost:6379/0",
    backend="redis://localhost:6379/1",
    include=["tasks"],
)

app.conf.update(
    task_track_started=True,
    worker_prefetch_multiplier=1,
)
Aqui existem duas URLs parecidas fazendo trabalhos diferentes.
redis://localhost:6379/0 → broker
redis://localhost:6379/1 → result backend
O broker transporta as tarefas.
O result backend guarda estados e resultados quando a aplicação precisa consultá-los. Ele não é obrigatório. Em muitos sistemas corporativos, o estado de negócio — PROCESSING, READY, FAILED — fica no banco principal, e o resultado bruto da tarefa nem precisa permanecer no backend do Celery.
Usar bancos lógicos 0 e 1 ajuda a separar nomes de chaves em uma instância Redis Open Source, mas isso não cria isolamento de infraestrutura: os bancos continuam pertencendo ao mesmo servidor e à mesma política de persistência. A própria documentação do Redis descreve bancos lógicos como namespaces, não como instâncias independentes.
Agora tasks.py:
from celery_app import app


@app.task(
    autoretry_for=(ConnectionError, TimeoutError),
    retry_backoff=True,
    retry_jitter=True,
    retry_kwargs={"max_retries": 5},
)
def processar_documento(document_id: int):
    texto = extrair_texto(document_id)
    chunks = dividir_em_chunks(texto)
    gerar_e_indexar_embeddings(document_id, chunks)
    return {"document_id": document_id, "chunks": len(chunks)}
O objetivo desse exemplo não é dizer que todo erro merece retry. Erro de rede temporário pode merecer. PDF inválido provavelmente não. Repetir cinco vezes um arquivo corrompido apenas transforma um erro determinístico em cinco erros mais caros.
Subimos o worker:
celery -A celery_app worker \
  --loglevel=INFO \
  --queues=rag_ingest \
  --concurrency=4
E publicamos a tarefa:
processar_documento.apply_async(
    args=[8472],
    queue="rag_ingest",
)
Nesse momento API e worker nem precisam existir no mesmo processo ou na mesma máquina. Precisam conseguir acessar o mesmo broker e os recursos necessários à tarefa.
Essa separação é o coração da arquitetura.
A fila resolve o acoplamento e cria novos problemas
Separar a API do processamento traz vantagens claras. Se o volume de documentos crescer, podemos aumentar a quantidade de workers sem necessariamente aumentar a quantidade de processos HTTP. Se o serviço de embeddings ficar lento, a API ainda consegue aceitar requisições até o limite definido. Se um trabalho for pesado, ele não precisa ocupar a conexão do usuário durante todo o processamento.
Mas a fila não elimina problemas. Ela troca um conjunto de problemas por outro mais administrável.
Agora precisamos responder perguntas que uma função local raramente exige:
- O que acontece se o
workermorrer no meio da tarefa? - A mensagem volta para a fila?
- Quem confirma que o trabalho terminou?
- Se a tarefa for entregue duas vezes, o que acontece?
- Se um serviço externo falhar por 500 milissegundos, tentamos novamente?
- Quantas vezes?
- Todos os
workerstentam ao mesmo tempo?
Esse vocabulário nos leva a acknowledgment, redelivery, retry, backoff e idempotência.
Ack: alguém precisa dizer “terminei”
Em sistemas de mensagens, ack é a confirmação de que determinada mensagem foi processada.
No Celery, a configuração exata depende do transporte e das opções adotadas. A documentação atual explica que, por padrão, tarefas são normalmente reconhecidas antes da execução; com acks_late, o reconhecimento pode acontecer depois. Isso aumenta a possibilidade de redelivery quando ocorre uma falha durante a execução, mas exige que a tarefa suporte ser executada mais de uma vez.
Quando Redis é usado como broker, o transporte precisa simular garantias que Redis não oferece como um broker AMQP nativo. A documentação atual do Celery explica que uma mensagem retirada da lista da fila é mantida em estruturas de mensagens não reconhecidas (unacked) enquanto aguarda confirmação. O instante da entrega também é acompanhado para que mensagens abandonadas possam voltar a circular.
É daí que aparece o visibility timeout: se uma tarefa ficar tempo demais sem ser reconhecida, ela pode ser entregue novamente. A documentação atual do transporte Redis registra uma hora como valor padrão. Uma tarefa que legitimamente demora mais do que esse intervalo pode, portanto, ser candidata a redelivery se a configuração não refletir o workload.
Ativar reconhecimento tardio é simples:
@app.task(acks_late=True)
def processar_documento(document_id):
    ...
O raciocínio por trás dele não é simples: se o processo morrer depois de produzir algum efeito externo, mas antes do ack, a tarefa poderá reaparecer. Por isso acks_late e idempotência costumam andar juntos.
O sistema está sendo teimoso por um motivo: é preferível em muitos cenários correr o risco de repetir um trabalho do que perdê-lo silenciosamente.
Só que agora sua função precisa conviver com repetição.
Idempotência: o antídoto contra o botão apertado duas vezes
Imagine uma tarefa:
@app.task
def cobrar_cliente(pedido_id):
    gateway.cobrar(pedido_id)
Se a mensagem for entregue novamente depois de uma falha de comunicação, temos uma pergunta desconfortável:
cobrar o mesmo pedido duas vezes é aceitável?
Provavelmente não.
Uma tarefa idempotente é construída para que repetir a mesma operação com a mesma identidade não produza um estado final incorreto.
No nosso pipeline de RAG, poderíamos usar uma chave determinística:
embedding:{document_id}:{chunk_id}:{model_version}
Antes de gerar ou gravar novamente, o sistema verifica se aquele artefato já existe na mesma versão. Outra estratégia é registrar estados de processamento em uma tabela transacional e avançar apenas quando a etapa anterior estiver concluída.
O ponto não é decorar a palavra idempotência. É perceber que repetição deixa de ser exceção quando mensagens atravessam rede, processos e filas.
O Celery recomenda explicitamente pensar tarefas como idempotentes quando existe possibilidade de reexecução. Esse não é um capricho de framework. É engenharia defensiva.
Retry sem backoff é uma multidão batendo na mesma porta
Suponha que o serviço de embedding responda com erro temporário.
Uma reação natural é tentar novamente:
for _ in range(10):
    try:
        gerar_embedding(texto)
        break
    except Exception:
        continue
Agora imagine 500 workers fazendo isso ao mesmo tempo.
O serviço que já estava com dificuldade recebe uma nova avalanche de chamadas imediatamente. A tentativa de recuperação ajuda a derrubar o que restava.
É por isso que retries costumam usar backoff: espera-se progressivamente mais entre as tentativas. Jitter adiciona uma pequena aleatoriedade para evitar que todos os consumidores acordem exatamente no mesmo instante.
O Celery possui suporte a retry_backoff e retry_jitter. Novamente, o conceito é maior do que a ferramenta: falhas transitórias precisam de recuperação controlada, não de insistência desesperada.
Prefetch: o worker pode pegar trabalho antes de estar pronto para executá-lo
Imagine dois caixas de supermercado.
O primeiro pega dez clientes da fila e manda todos ficarem parados ao lado do seu caixa. O segundo continua livre, olhando para a fila quase vazia.
Tecnicamente existem dois caixas. Na prática, a distribuição ficou ruim.
Workers podem fazer algo parecido por meio de prefetch: reservar mensagens antecipadamente para reduzir o custo de buscar uma nova tarefa a cada execução.
Isso é ótimo quando existem muitas tarefas curtas. A próxima já está perto quando o slot fica livre.
Mas pode ser ruim quando uma fila mistura trabalhos de durações muito diferentes.
Na configuração atual do Celery, worker_prefetch_multiplier controla quantas mensagens podem ser reservadas por slot de concorrência. O valor padrão documentado é 4. Para tarefas longas, reduzir esse multiplicador para 1 costuma melhorar a distribuição entre workers.
app.conf.worker_prefetch_multiplier = 1
Na série 5.6, o Celery também passou a documentar worker_disable_prefetch para o transporte Redis, fazendo o worker buscar uma nova tarefa apenas quando existir um slot de execução livre.
Isso não significa que “prefetch é ruim”. Significa que throughput e justiça de distribuição nem sempre apontam para a mesma configuração.
Mil tarefas de 20 milissegundos gostam de um comportamento diferente de cinquenta OCRs de quinze minutos.
Filas separadas permitem que trabalhos diferentes parem de brigar
Agora imagine que a mesma fila receba:
extrair PDF pequeno        → 2 segundos
OCR de documento escaneado → 4 minutos
reindexar 50 mil arquivos  → horas
Se tudo for tratado como trabalho equivalente, tarefas rápidas podem ficar presas atrás de operações enormes.
Celery permite rotear tarefas para filas diferentes:
app.conf.task_routes = {
    "tasks.processar_documento": {"queue": "rag_ingest"},
    "tasks.reindexar_base": {"queue": "rag_batch"},
}
Podemos então criar trabalhadores com perfis diferentes:
celery -A celery_app worker -Q rag_ingest -c 4 -l INFO
celery -A celery_app worker -Q rag_batch -c 2 -l INFO
Agora o lote histórico não precisa sequestrar todos os slots usados por documentos recém-enviados.
Essa divisão também facilita escalar apenas o gargalo. Se rag_ingest possui backlog e rag_batch está vazio, aumentamos consumidores onde existe pressão real.
Fila deixa de ser apenas uma caixa de espera.
Ela passa a ser parte do desenho de capacidade.
E então aparece o Redis — quase sempre sendo chamado apenas de cache
Redis nasceu como Remote Dictionary Server e é frequentemente apresentado como banco de chave-valor em memória. A Wikipédia usa essa descrição de forma resumida, enquanto a documentação oficial prefere enfatizar que Redis é um servidor de estruturas de dados.
A segunda definição é mais útil.
Porque Redis não guarda apenas algo parecido com:
nome → "Ana"
Ele oferece estruturas como strings, hashes, sets, sorted sets, streams, JSON, estruturas probabilísticas, séries temporais e recursos vetoriais. Cada estrutura existe porque certos problemas ficam mais baratos e naturais quando o servidor entende a operação que estamos tentando executar.
É a diferença entre guardar todos os ingredientes soltos no chão e ter gavetas projetadas para facas, panelas e temperos.
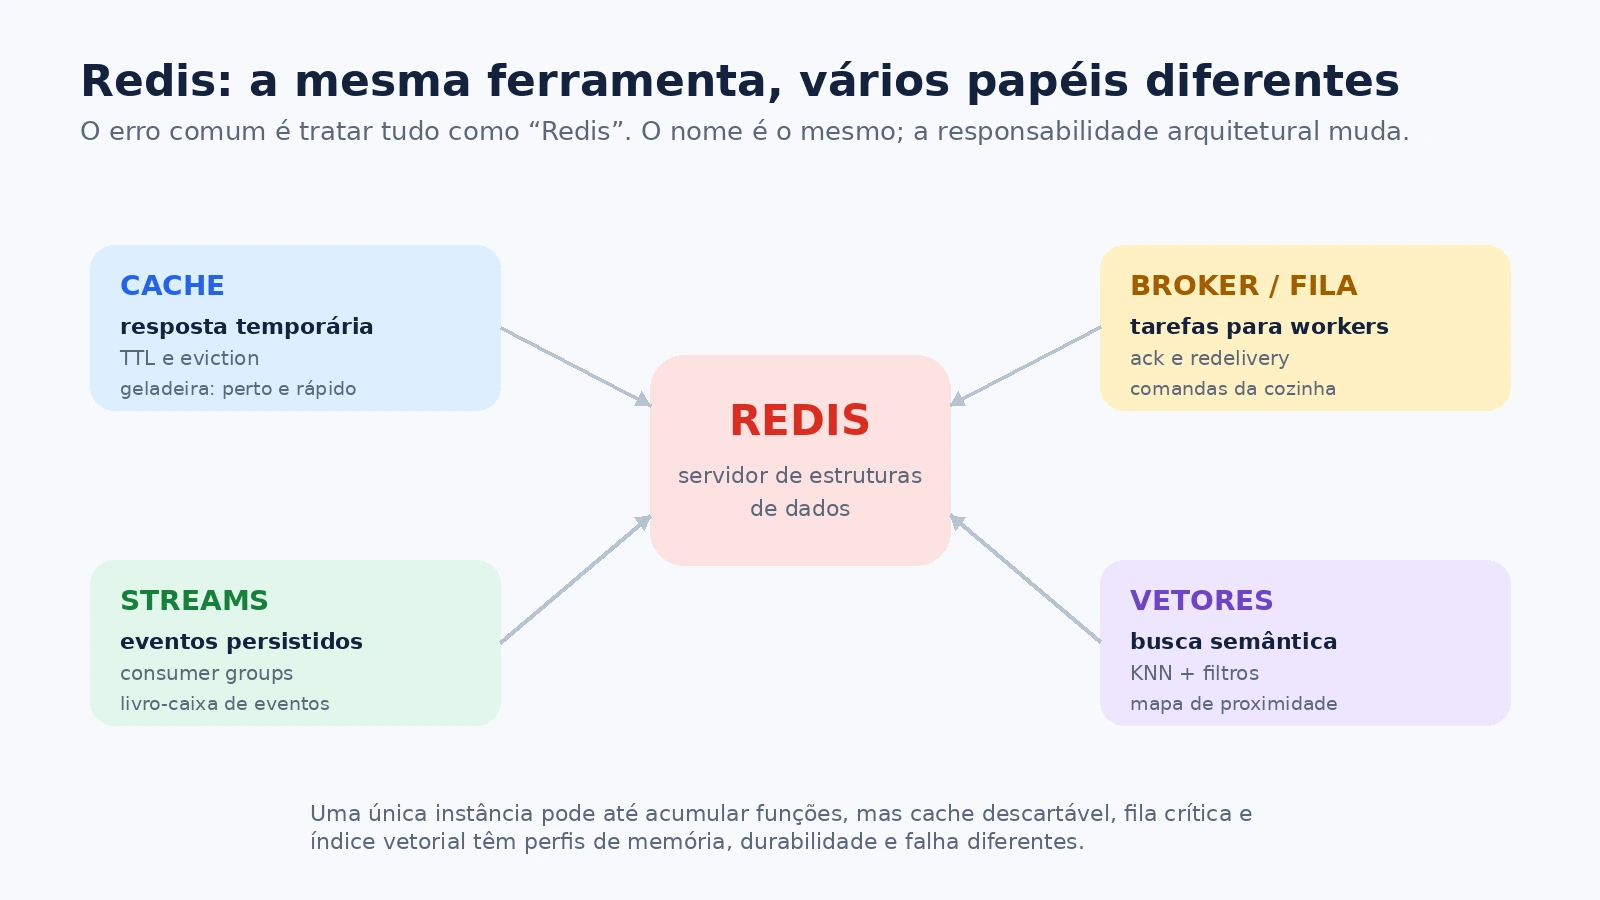
Essa versatilidade explica por que Redis aparece tanto em arquiteturas modernas. Também explica por que às vezes ele vira o armário onde a equipe tenta guardar qualquer coisa.
A pergunta correta não é “Redis consegue?”.
Quase sempre ele consegue alguma versão da ideia.
A pergunta melhor é: qual responsabilidade estou colocando nele, com qual requisito de durabilidade, memória, latência e recuperação?
“In-memory” não significa “sem persistência”
Outra simplificação comum é dizer que Redis “fica na RAM, então se reiniciar perde tudo”.
Redis é fortemente associado a processamento em memória, mas oferece mecanismos de persistência. A documentação oficial descreve quatro possibilidades principais: RDB, AOF, combinar os dois ou operar sem persistência.
RDB: uma fotografia periódica
RDB cria snapshots do conjunto de dados em determinados momentos.
Pense em fotografar um quadro branco de tempos em tempos. Se a sala pegar fogo, você consegue reconstruir o quadro até a última fotografia — mas alterações feitas depois dela podem ter desaparecido.
AOF: um diário das escritas
AOF, Append Only File, registra operações de escrita. Durante a recuperação, essas operações podem ser reproduzidas para reconstruir o estado.
É mais parecido com um livro-caixa: em vez de guardar só a fotografia final, você mantém o histórico de alterações necessárias para remontá-la.
Nenhuma opção é “sempre melhor”. Existem diferenças de durabilidade, custo de escrita, tempo de recuperação e tamanho de armazenamento.
Essa discussão importa porque o mesmo Redis pode estar sendo usado para um cache descartável em um ambiente e para estado que não pode desaparecer em outro.
Quando Redis é o broker do Celery, isso deixa de ser teoria. As mensagens pendentes são chaves normais do Redis; portanto, a sobrevivência da fila a um restart depende da política de persistência configurada no servidor. A documentação do Celery alerta que apenas snapshots RDB podem permitir a perda das tarefas publicadas depois do último snapshot; AOF reduz essa janela conforme a política de fsync adotada.
Existe ainda um segundo cuidado: eviction.
Um Redis usado exclusivamente como cache pode ser configurado para remover chaves quando a memória enche. Para um broker, remover uma chave de fila para abrir espaço não é “limpar cache”. É perder trabalho.
Por isso produção exige decidir conscientemente se broker, cache, sessão e índice vetorial realmente devem compartilhar o mesmo domínio de memória e falha.
Cache: a geladeira continua sendo uma boa analogia
Se existe um banco de dados permanente, por que colocar uma cópia de determinados dados no Redis?
Pelo mesmo motivo que você possui uma geladeira mesmo existindo supermercado.
Ir ao supermercado toda vez que quiser manteiga seria possível. Só seria ridículo.
O cache aproxima dados usados com frequência do caminho quente da aplicação. A ideia funciona quando o custo de recuperar ou recalcular algo na origem é maior do que manter uma cópia temporária.
Em Redis, chaves podem possuir TTL (Time To Live): depois de determinado tempo, expiram. Quando existe limite de memória, políticas de eviction podem definir o que acontece quando o espaço termina.
Isso introduz duas perguntas fundamentais:
- Quanto tempo essa informação continua válida?
- O sistema continua correto se o cache desaparecer?
A segunda é a mais importante.
Se apagar o cache derruba a integridade do negócio, talvez aquilo não fosse apenas cache.
Pub/Sub e Streams parecem primos, mas se comportam de forma diferente
Redis também possui Pub/Sub.
Um processo publica uma mensagem em um canal:
PUBLISH documentos.atualizados "8472"
Clientes inscritos naquele canal recebem o evento enquanto estão conectados.
É excelente para atualizações efêmeras: presença, notificações em tempo real, invalidação de cache, eventos de interface e situações em que perder uma mensagem antiga não é necessariamente um desastre.
A documentação do Redis é explícita: Pub/Sub usa semântica at-most-once. Se o assinante não recebeu a mensagem, ela não fica guardada esperando pacientemente o retorno dele.
Streams resolvem outra classe de problema.
Um Redis Stream funciona como uma estrutura append-only: novas entradas são acrescentadas, recebem identificadores e podem ser lidas posteriormente. Consumer groups permitem coordenar consumidores, acompanhar itens pendentes e confirmar processamento com comandos como XACK.
Uma comparação prática:
| Mecanismo | A mensagem fica armazenada? | Coordenação de consumidores | Uso típico |
|---|---|---|---|
Pub/Sub |
não como histórico para replay | simples broadcast | eventos efêmeros e tempo real |
Streams |
sim | consumer groups, pendências, ack |
pipelines de eventos e processamento |
Broker de tarefas |
depende do transporte/framework | orientado a tarefas | execução assíncrona por workers |
Cache |
temporariamente | não é o objetivo | reduzir custo e latência |
A lição é simples: duas tecnologias podem transportar “mensagens” e ainda assim oferecer garantias muito diferentes.
Até aqui, nenhuma IA foi necessária
Isso é proposital.
A maior parte da robustez de uma aplicação de IA vem de coisas que já existiam antes da atual geração de LLMs: filas, controle de concorrência, índices, cache, autenticação, telemetria, isolamento de falhas e persistência.
Agora vamos acrescentar o problema que RAG tenta resolver.
Uma empresa possui 30 mil documentos: contratos, procedimentos, artigos internos, manuais, tickets antigos, páginas de wiki e políticas comerciais.
Queremos que um modelo responda perguntas usando esse material.
A primeira ideia de quem está começando costuma ser:
“É só mandar os documentos no prompt.”
É o equivalente computacional de resolver mudança de apartamento levando a casa inteira dentro do carro.
Mesmo quando uma janela de contexto é grande, enviar material demais aumenta latência, custo e ruído. Pior: o documento relevante pode estar perdido entre milhares de trechos que não ajudam em nada.
Precisamos recuperar a parte certa antes de gerar a resposta.
É aí que entra RAG.
RAG nasceu para colocar uma memória consultável ao lado do modelo
RAG significa Retrieval-Augmented Generation, ou geração aumentada por recuperação.
O trabalho de Patrick Lewis e colaboradores, publicado em 2020, apresentou uma formulação que combinava duas formas de memória:
- memória paramétrica: conhecimento representado nos parâmetros do modelo;
- memória não paramétrica: informação recuperada externamente a partir de um índice.
No trabalho original, o índice não paramétrico era construído sobre passagens da Wikipédia e consultado por um recuperador denso. A ideia central se espalhou porque resolve um problema arquitetural importante: conhecimento externo pode ser atualizado sem exigir que cada alteração seja incorporada novamente aos parâmetros do modelo.
Se uma política muda hoje, podemos atualizar a fonte e reindexá-la. Não precisamos “ensinar novamente toda a empresa” ao LLM.
A documentação atual do Redis resume um RAG em três verbos:
Retrieve → Augment → Generate
Ou:
- recuperar informação relevante;
- acrescentá-la ao contexto da pergunta;
- gerar uma resposta usando esse contexto.
Só que existe uma parte escondida antes desses três verbos.
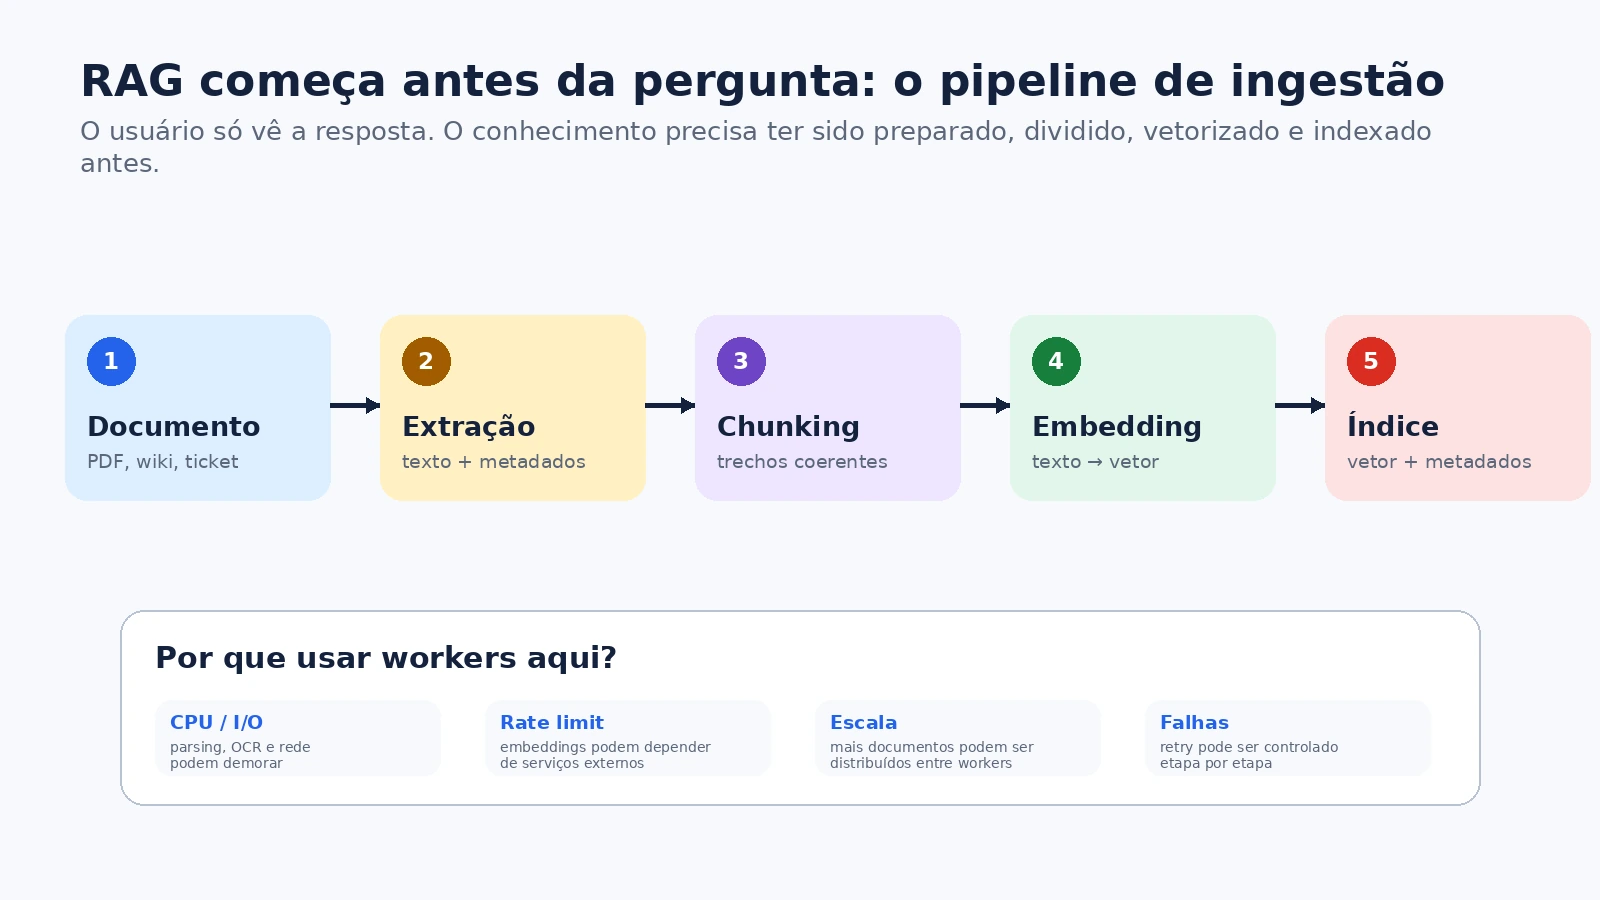
Os documentos precisam ser preparados.
RAG começa antes da pergunta: ingestão
Quando alguém sobe um PDF, esse arquivo ainda não é automaticamente útil para busca semântica.
Existe um pipeline anterior:
1. Extração
Primeiro precisamos transformar o formato original em conteúdo processável.
Em um PDF de texto, talvez seja relativamente simples. Em um documento digitalizado, OCR pode ser necessário. Em uma apresentação, a ordem visual dos elementos pode não corresponder à ordem lógica do texto. Em tabelas, extrair células sem preservar cabeçalhos pode destruir o significado.
Uma tabela como esta:
| Plano | Cancelamento |
|---|---|
| Basic | 7 dias |
| Enterprise | 30 dias |
pode virar, depois de um parser ruim:
Plano Cancelamento Basic Enterprise 7 dias 30 dias
Tecnicamente extraímos todas as palavras.
Semanticamente destruímos a tabela.
RAG é extremamente dependente da qualidade dessa etapa.
2. Limpeza e metadados
Além do texto, normalmente precisamos preservar contexto estrutural:
{
  "document_id": 8472,
  "titulo": "Política Comercial",
  "secao": "Cancelamento",
  "pagina": 17,
  "versao": "2026-08",
  "departamento": "comercial",
  "tenant_id": 27,
  "classificacao": "interna"
}
Esses campos parecem burocráticos até o dia em que precisamos responder apenas com a versão vigente ou impedir que um usuário veja documentos de outro cliente.
3. Chunking
Depois, o conteúdo é dividido em partes menores: os chunks.
E aqui mora uma das decisões mais subestimadas de todo projeto de RAG.
Chunking: cortar texto é fácil; cortar significado é o problema
Imagine uma política com este trecho:
Cancelamento do plano Enterprise

O cliente pode solicitar o encerramento a qualquer momento.
O pedido deve ser realizado com antecedência mínima de 30 dias.
Não há cobrança de multa quando o aviso respeita esse prazo.
Agora suponha que o algoritmo divida o texto exatamente no meio:
Chunk A
Cancelamento do plano Enterprise
O cliente pode solicitar o encerramento a qualquer momento.
Chunk B
O pedido deve ser realizado com antecedência mínima de 30 dias.
Não há cobrança de multa quando o aviso respeita esse prazo.
Se alguém perguntar “qual é o prazo do Enterprise?”, o chunk que contém “30 dias” não contém mais “Enterprise”. Dependendo da estratégia de recuperação, perdemos uma ligação importante.
No outro extremo, fazer um chunk com um manual inteiro também é ruim: o vetor passa a representar muitos assuntos ao mesmo tempo, e o contexto enviado ao modelo carrega muito ruído.
É como recortar um livro para fazer fichas de estudo.
Se cada ficha tiver uma palavra, nenhuma explica coisa alguma. Se cada ficha tiver o livro inteiro, deixou de ser ficha.
Estratégias comuns usam parágrafos, cabeçalhos, seções, quantidade aproximada de tokens, sobreposição (overlap) ou divisão semântica. Nenhuma delas é universalmente correta.
O tamanho ideal depende de:
- tipo do documento;
- tamanho das respostas esperadas;
- modelo de embedding;
- mecanismo de busca;
- necessidade de preservar tabelas e listas;
- custo de enviar contexto ao LLM.
Esse é um bom exemplo de onde benchmark genérico ajuda menos do que avaliação com os documentos reais do sistema.
Embeddings: transformar significado em geometria
Depois de criar os chunks, precisamos torná-los pesquisáveis semanticamente.
Um modelo de embedding recebe texto e devolve um vetor numérico.
Algo como:
"prazo para cancelar contrato"
        ↓
[0.018, -0.294, 0.117, ..., 0.083]
O vetor pode ter centenas ou milhares de dimensões, dependendo do modelo. Cada posição isolada geralmente não possui um significado humano simples do tipo “dimensão 37 = contratos”. O valor está na geometria coletiva.
Textos que o modelo representa como semanticamente relacionados tendem a produzir vetores próximos de acordo com determinada métrica.
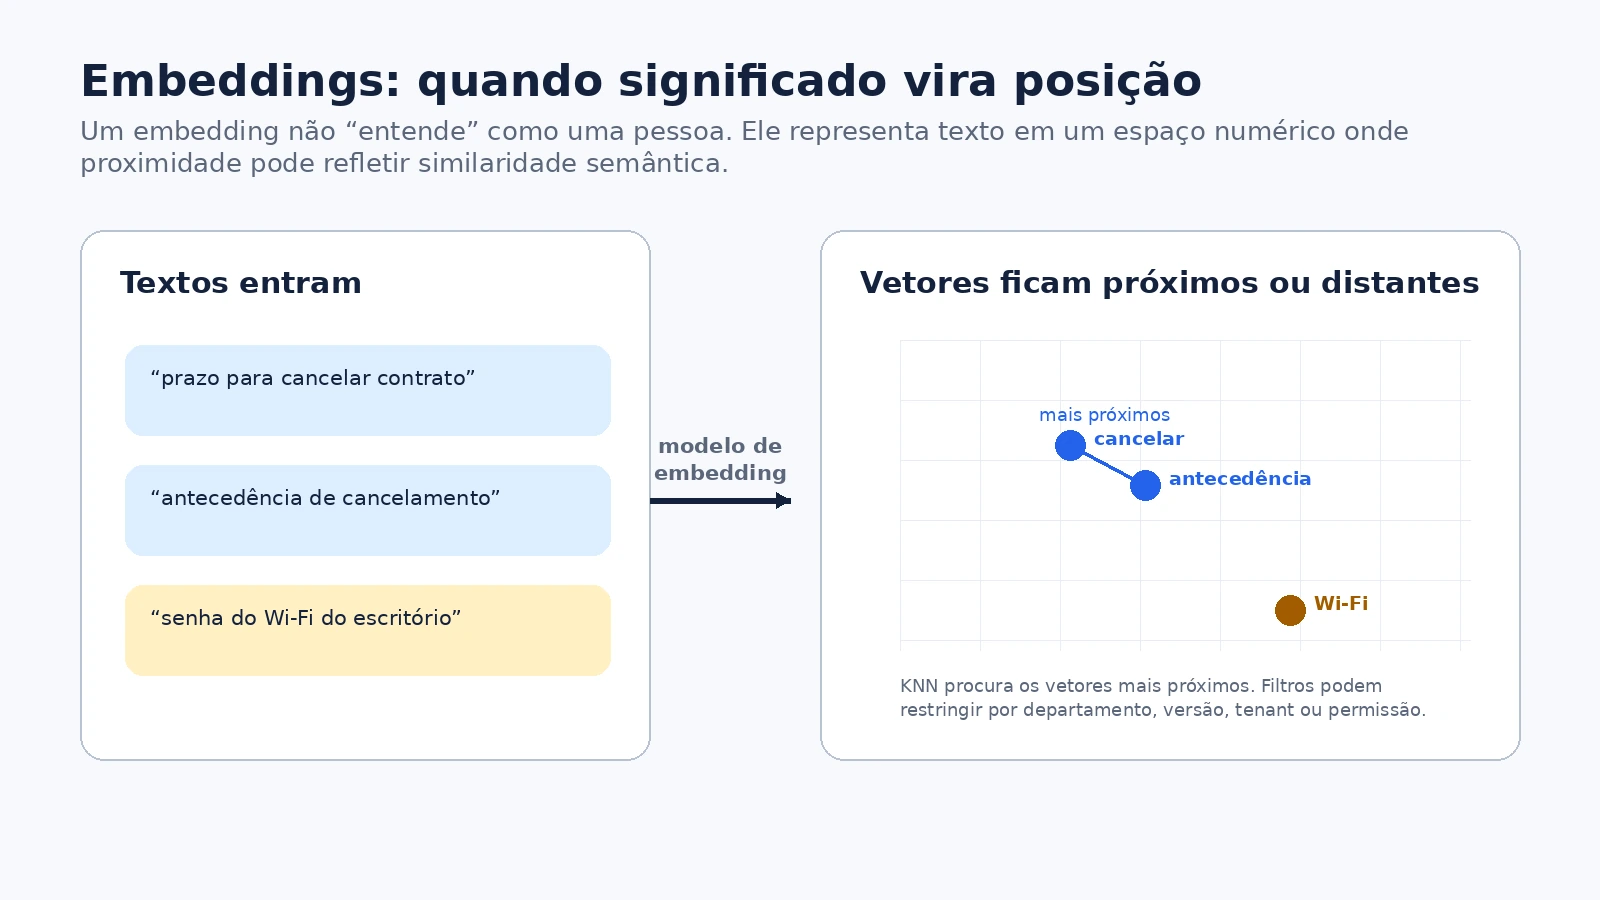
Essa ideia é poderosa porque a consulta não precisa repetir exatamente as palavras do documento.
Documento:
O pedido deve ser realizado com antecedência mínima de 30 dias.
Pergunta:
Quanto tempo antes eu preciso avisar que vou encerrar?
Uma busca puramente lexical pode depender da coincidência de termos. Busca vetorial tenta capturar proximidade semântica.
O trabalho Dense Passage Retrieval for Open-Domain Question Answering, também de 2020, ajudou a demonstrar a eficácia de representações densas para recuperar passagens em tarefas de perguntas e respostas. RAG herdou muito dessa lógica de recuperação densa.
Mas embedding não é telepatia.
Ele cria uma representação útil para similaridade. Não garante que dois textos próximos sejam logicamente equivalentes.
Essa diferença volta a nos assombrar quando falamos de semantic cache.
Distância: como o sistema decide o que está “perto”?
Se temos vetores, precisamos de uma forma de comparar proximidade.
Redis suporta métricas como COSINE, distância Euclidiana (L2) e IP (inner product) em campos vetoriais, dependendo da configuração do índice.
Não precisamos transformar este artigo em aula de álgebra linear, mas a intuição importa.
Distância Euclidiana (L2)
É a versão multidimensional da distância de régua entre dois pontos.
Similaridade de cosseno
Compara principalmente a direção dos vetores. Dois vetores apontando para direções parecidas podem ser considerados similares mesmo quando possuem magnitudes diferentes.
Produto interno (IP)
Combina direção e magnitude de acordo com a representação usada pelo modelo.
A escolha precisa ser compatível com o modelo de embedding e com a forma como ele foi treinado ou normalizado.
Trocar a métrica sem entender o embedding é como usar quilômetros para medir temperatura: o cálculo pode até produzir número, mas o significado foi embora.
Redis entra novamente — agora como índice vetorial
A documentação atual do Redis permite definir campos VECTOR em estruturas indexadas e executar consultas de vizinhos mais próximos (KNN) ou por raio de distância. Também é possível combinar a busca vetorial com filtros de texto, tags, números e outros campos.
Isso permite guardar um registro conceitualmente assim:
{
  "id": "chunk:8472:17:4",
  "content": "O pedido deve ser realizado com antecedência mínima de 30 dias.",
  "document_id": 8472,
  "department": "comercial",
  "status": "vigente",
  "tenant_id": 27,
  "embedding": [0.018, -0.294, 0.117]
}
Quando chega a pergunta, geramos outro vetor e buscamos os K vizinhos mais próximos.
Se K = 5, queremos cinco candidatos.
Até aí parece simples.
O problema aparece quando o índice possui milhões de vetores.
FLAT: a pessoa que bate em todas as portas
A forma conceitualmente mais direta de encontrar o vetor mais próximo é comparar a consulta com todos os vetores existentes.
É uma busca exata por força bruta.
Redis oferece o algoritmo FLAT para esse tipo de índice.
Imagine procurar um endereço em uma cidade visitando todas as casas, uma por uma, e perguntando:
“É aqui?”
Você eventualmente encontra. A estratégia é impecavelmente correta e absurdamente pouco ambiciosa.
Em bases pequenas ou quando exatidão tem prioridade e o custo é aceitável, essa simplicidade pode ser uma vantagem.
Conforme o número de vetores cresce, comparar tudo começa a ficar caro.
É aí que algoritmos aproximados entram em cena.
HNSW: em vez de visitar todas as casas, construa ruas de atalho
HNSW significa Hierarchical Navigable Small World.
A ideia, simplificada, é organizar vetores em uma estrutura de grafo com conexões que permitem navegar rapidamente por regiões promissoras do espaço de busca.
Em vez de comparar a consulta com tudo, o algoritmo percorre conexões e vai se aproximando de candidatos melhores.
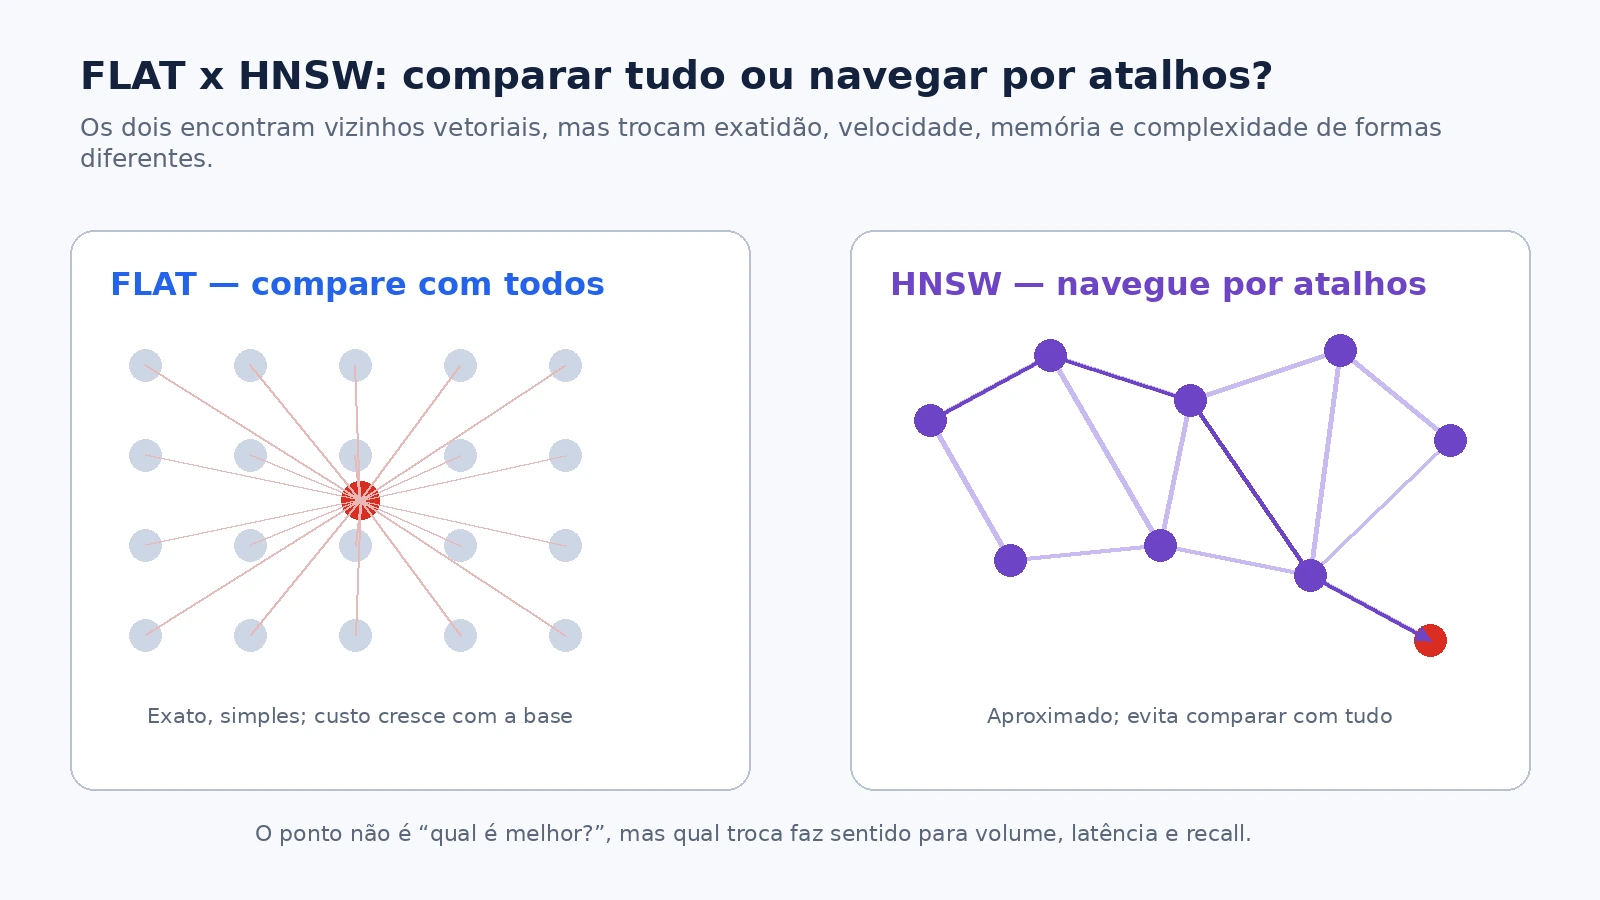
O preço aparece na palavra que normalmente acompanha esses índices: aproximado.
Podemos deixar de visitar algum vizinho matematicamente perfeito para ganhar velocidade em grandes coleções.
Aqui surge um trade-off entre:
recall da busca ←──────────────→ custo / latência / memória
A documentação atual do Redis também apresenta SVS-VAMANA, voltado a cenários de grande escala e uso de técnicas de compressão. O detalhe específico da implementação pode evoluir; o princípio permanece: índices vetoriais escolhem estruturas diferentes para equilibrar precisão, memória e tempo de consulta.
Não existe almoço grátis nem em 768 dimensões.
Busca semântica sozinha também consegue trazer o documento errado
Considere a pergunta:
Como cancelar um contrato?
A empresa possui documentos sobre:
- contratos de clientes;
- contratos de fornecedores;
- contratos trabalhistas;
- licenças de software;
- acordos de parceria.
Todos podem ser semanticamente parecidos.
Se a busca olhar apenas para proximidade vetorial, ela pode trazer uma passagem correta sobre o assunto errado.
É por isso que metadados e filtros são tão importantes.
Podemos buscar algo equivalente a:
tenant_id = 27
AND status = "vigente"
AND departamento IN permissoes_do_usuario
AND vector KNN 10
Redis suporta consultas híbridas nas quais filtros estruturados restringem os candidatos da busca vetorial.
Esse detalhe possui implicação de segurança.
Similaridade não é autorização
Um documento pode ser extremamente parecido com a pergunta e, ainda assim, ser proibido para aquele usuário.
A autorização precisa acontecer antes de o conteúdo entrar no contexto do modelo.
Depois que um segredo foi enviado para o LLM, colocar no prompt “por favor, não revele este segredo” não é uma fronteira de segurança confiável.
RAG não é apenas problema de busca.
Também é controle de acesso.
Busca híbrida: às vezes a palavra exata importa mais que a semântica
Busca vetorial é excelente para frases como:
Como encerro meu contrato?
versus:
procedimento para cancelamento
Mas existem consultas em que tokens exatos são fortíssimos sinais:
ORA-12514
KB5030219
ERR_CONNECTION_RESET
AB-8472-X
Um código de erro não precisa ser “compreendido poeticamente”. Ele precisa ser encontrado.
Por isso sistemas de recuperação maduros frequentemente combinam busca lexical e busca vetorial. A primeira valoriza coincidência de termos; a segunda procura proximidade semântica.
Depois, os resultados podem ser combinados ou reordenados.
A discussão “keyword search morreu?” é pouco útil.
Chave de fenda não morreu quando inventaram furadeira.
Reranking: primeiro encontre candidatos; depois pense mais caro
Suponha que existam dez milhões de chunks.
Usar um modelo sofisticado para comparar a pergunta profundamente com todos eles seria caro demais.
Uma estratégia comum é trabalhar em funil:
10.000.000 chunks
       │
       │ recuperação rápida
       ▼
      50 candidatos
       │
       │ reranking mais caro
       ▼
       5 melhores
       │
       ▼
    contexto do LLM
O primeiro estágio prioriza recall: tente não perder bons candidatos.
O segundo pode usar um mecanismo mais caro para melhorar precisão e ordenar os trechos encontrados.
Surveys recentes sobre RAG passaram justamente a separar a arquitetura em fases de pré-recuperação, recuperação, pós-recuperação e geração. Isso mostra o quanto o termo RAG ficou maior do que o desenho básico “busque três textos e cole no prompt”.
Só agora chegamos ao G de RAG
Depois de extração, chunking, embedding, indexação, filtros, recuperação e talvez reranking, podemos montar um contexto:
Pergunta:
Qual é o prazo para cancelar o plano Enterprise?

Contexto recuperado:
Documento: Política Comercial
Versão: 2026-08
Página: 17

"O pedido deve ser realizado com antecedência mínima de 30 dias."
O LLM recebe instruções junto com esse material:
Responda com base apenas nas evidências fornecidas.
Quando a informação não estiver presente, informe que
não há evidência suficiente.
Cite o documento e a página utilizados.
Agora acontece a geração.
Perceba a inversão de protagonismo: em uma boa arquitetura RAG, o LLM pode ser a última grande etapa, não a primeira.
Isso muda completamente o troubleshooting.
“A IA alucinou” é um diagnóstico preguiçoso quando existe RAG
Se a resposta está errada, o modelo pode ser culpado.
Mas talvez o documento correto nunca tenha sido indexado.
Talvez o parser tenha destruído uma tabela.
Talvez o chunking tenha separado título e conteúdo.
Talvez o filtro de versão tenha escolhido um documento antigo.
Talvez a busca vetorial tenha retornado candidatos ruins.
Talvez o reranker tenha colocado a passagem certa em sexto lugar e você só enviou cinco.
Talvez o contexto tenha sido truncado.
E só então chegamos à possibilidade de o LLM ter interpretado errado uma evidência correta.
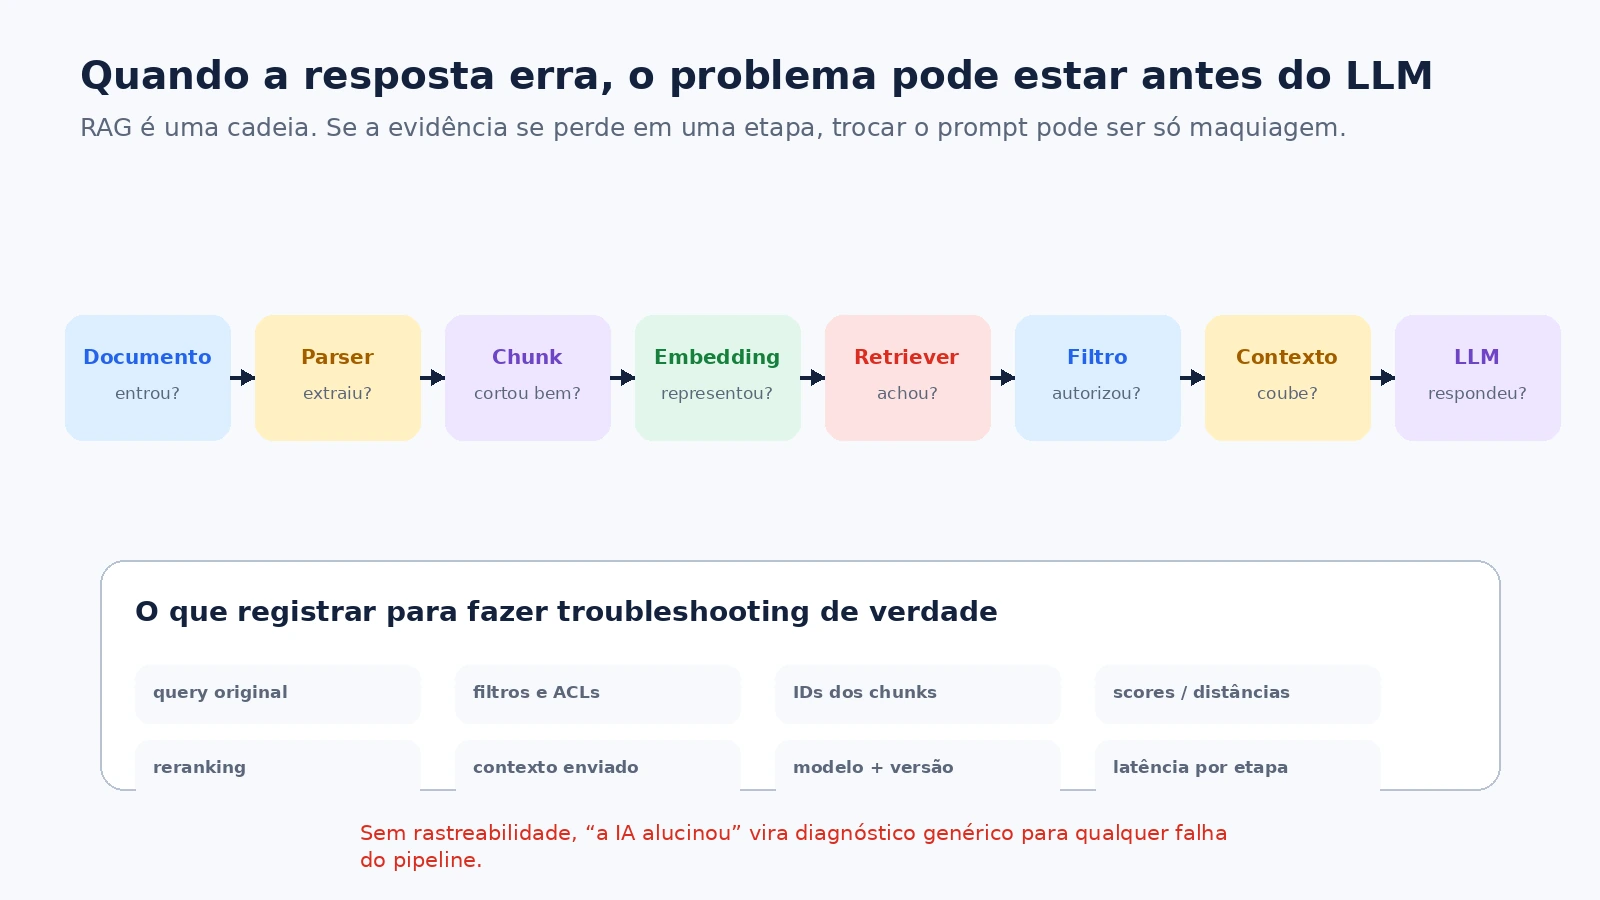
Uma aplicação que registra apenas o prompt final perde a maior parte da história.
Para investigar uma consulta real, faz sentido preservar ao menos:
request_id
user_id / tenant_id
query original
embedding_model + versão
filtros aplicados
IDs dos chunks candidatos
scores / distâncias
ordem após reranking
contexto efetivamente enviado
modelo de geração + versão
latência por etapa
resposta final
fontes apresentadas
Com isso, troubleshooting deixa de ser ritual de trocar temperature e passa a ser análise de pipeline.
RAG reduz alguns erros; não transforma o LLM em banco de dados
Uma das promessas mais exageradas em torno de RAG é que ele “elimina hallucination”.
Não elimina.
O trabalho original de RAG foi motivado, entre outras coisas, pelas dificuldades de modelos puramente paramétricos em atualizar conhecimento, manipular fatos e oferecer proveniência. Acrescentar recuperação externa melhora o desenho, mas não remove a natureza generativa do modelo.
Mesmo com um contexto correto, um LLM ainda pode:
- interpretar mal uma passagem;
- misturar duas fontes incompatíveis;
- extrapolar além da evidência;
- ignorar uma condição importante;
- produzir uma afirmação não sustentada pelos documentos.
Por isso sistemas de maior risco precisam de mecanismos adicionais: citação de fontes, respostas abstidas quando não existe evidência suficiente, validação, regras determinísticas e, em alguns domínios, revisão humana.
RAG é uma arquitetura de recuperação + geração.
Não é certificado de verdade.
Redis pode guardar cache semântico — e aí mora uma pegadinha elegante
Depois que o sistema funciona, alguém percebe que várias perguntas são parecidas:
Qual o prazo para cancelar?

Com quantos dias preciso avisar o cancelamento?

Qual a antecedência para encerrar o contrato?
Um cache tradicional baseado na string completa enxergaria três chaves diferentes.
Um semantic cache pode gerar embeddings das perguntas e verificar se uma nova consulta é suficientemente próxima de outra já respondida.
Se for, a aplicação pode reutilizar a resposta e evitar parte do pipeline:
sem cache semântico:
query → embedding → retrieval → rerank → LLM → resposta

com cache semântico:
query → similaridade → resposta reaproveitada
Redis possui ferramentas voltadas a esse padrão em seu ecossistema de IA.
Parece brilhante — até compararmos:
Posso cancelar o contrato?
com:
Posso cancelar o contrato sem multa?
Semanticamente, são próximas.
No negócio, a segunda acrescenta uma condição decisiva.
O limiar de similaridade do cache não é apenas um parâmetro matemático. É uma decisão de risco.
Quanto maior o impacto de uma resposta errada, mais conservador o reaproveitamento precisa ser.
Redis também pode guardar memória de conversa — mas o modelo não “lembrou”
Considere:
Usuário: Meu plano é Enterprise.
Assistente: Entendido.
Usuário: Qual é o prazo de cancelamento dele?
A segunda frase depende da primeira.
Podemos guardar histórico de sessão e reconstruir contexto a cada chamada. Redis é frequentemente usado para esse tipo de estado por sua baixa latência e suporte a TTL.
Conforme a conversa cresce, talvez não seja eficiente enviar tudo novamente. Podemos manter mensagens recentes, resumir blocos antigos ou recuperar lembranças relevantes semanticamente.
O ponto conceitual é importante:
O modelo não acordou lembrando da conversa anterior. A aplicação recuperou estado e entregou esse estado novamente ao modelo.
“Memória de IA” muitas vezes é arquitetura de armazenamento usando uma palavra mais simpática.
Quando o worker finalmente encontra o RAG
Agora podemos montar um fluxo de produção completo.
Caminho A — ingestão do conhecimento
Um administrador envia uma nova política comercial.
1. API recebe o arquivo
2. arquivo é salvo em storage
3. banco registra documento = PROCESSING
4. tarefa entra na fila
5. worker extrai conteúdo
6. worker divide em chunks
7. embeddings são gerados
8. vetores + metadados são indexados
9. versão antiga é desativada
10. documento = READY
Se a etapa 7 falhar temporariamente, podemos aplicar retry com backoff.
Se a tarefa repetir, a operação deve ser idempotente.
Se a fila crescer, podemos aumentar consumidores dentro dos limites dos serviços externos e do banco.
Caminho B — consulta do usuário
Horas depois:
1. usuário envia pergunta
2. autenticação identifica tenant e permissões
3. pergunta vira embedding
4. filtros limitam o universo autorizado
5. busca vetorial/lexical recupera candidatos
6. reranker ordena os melhores trechos
7. contexto é montado dentro do orçamento de tokens
8. LLM gera resposta
9. fontes são associadas
10. telemetria registra o caminho
Perceba que nem toda pergunta precisa passar por uma fila. A ingestão é um excelente candidato a processamento assíncrono porque pode ser pesada e não precisa bloquear o usuário. A consulta interativa, por outro lado, normalmente precisa retornar em poucos segundos.
Misturar os dois caminhos só porque ambos “usam IA” é uma ótima maneira de criar latência onde não precisava existir.
Backpressure: quando a fila precisa ensinar o sistema a esperar
Filas absorvem diferenças temporárias entre velocidade de entrada e velocidade de processamento.
Se entram 100 tarefas por minuto e os workers processam 120, tudo bem.
Se entram 1.000 por minuto e a capacidade continua em 120, a matemática não negocia:
fila(t) = fila(t-1) + entrada - processamento
Enquanto a entrada for maior, o backlog cresce.
Adicionar fila não criou capacidade. Criou amortecimento.
Esse detalhe é importante porque arquiteturas assíncronas às vezes escondem o colapso por alguns minutos: a API continua respondendo rápido enquanto a fila atrás dela vira um depósito infinito de promessas atrasadas.
Precisamos observar:
- tamanho da fila;
- idade da tarefa mais antiga;
- taxa de entrada;
- taxa de conclusão;
- taxa de erro e retry;
- tempo por tipo de tarefa.
E talvez aplicar backpressure: limitar uploads, reduzir produtores, priorizar determinados trabalhos ou dividir filas.
Por exemplo:
rag:urgente
rag:normal
rag:reindexacao
Uma pergunta de produção não deveria esperar atrás de 300 mil documentos de uma reindexação histórica apenas porque alguém decidiu usar a mesma fila para tudo.
Mais workers não significam mais capacidade para sempre
Se um worker processa dez documentos por minuto, parece natural supor que cem processam mil.
Até todos começarem a chamar o mesmo banco, usar o mesmo Redis, consumir a mesma API de embeddings e disputar a mesma CPU.
O gargalo apenas se move.
Imagine uma fábrica que consegue montar dez mil caixas por hora, mas possui um portão de saída que comporta mil.
Contratar mais gente para montar caixas transforma o pátio em estoque. Não aumenta a quantidade entregue.
Em pipelines de IA, limites comuns incluem:
rate limitdo provedor de modelos;- conexões com banco;
- CPU para parsing/OCR;
- memória;
- largura de banda;
- capacidade do índice;
- concorrência aceitável por tenant.
Escalar é aumentar a capacidade do sistema como cadeia, não apenas multiplicar processos.
Um Redis para tudo? Conveniente, até os requisitos começarem a brigar
Nosso diagrama agora possui Redis em vários lugares:
Redis para cache
Redis como broker
Redis para estado de sessão
Redis Streams
Redis para vetores
Isso pode ser ótimo operacionalmente. Uma equipe domina menos tecnologias e reaproveita monitoramento, automação e conhecimento.
Mas usar o mesmo produto não obriga usar a mesma instância nem o mesmo perfil operacional.
Considere as diferenças:
| Carga | O que valoriza | O que pode ser aceitável |
|---|---|---|
| cache | baixa latência | eviction de dados reaproveitáveis |
| fila crítica | entrega e recuperação | perder mensagem pode ser grave |
| sessão | expiração previsível | TTL é parte do comportamento |
| índice vetorial | memória e busca | reconstrução pode ser possível, mas custosa |
| stream de eventos | histórico/consumo | retenção precisa ser definida |
Se um índice vetorial enorme pressiona memória e aciona uma política inadequada de eviction, podemos prejudicar um workload que possuía requisitos totalmente diferentes.
Consolidação tecnológica é útil.
Acoplamento de falhas, nem sempre.
Quando NÃO usar RAG
Depois de aprender uma técnica nova, todo problema começa a parecer um prego educadamente solicitando um martelo.
RAG não é necessário para qualquer dado.
Se a pergunta é:
“Qual é o saldo atual do cliente 8472?”
E existe uma tabela transacional com esse valor, talvez a melhor ferramenta continue sendo:
SELECT saldo
FROM clientes
WHERE id = 8472;
Não precisamos transformar R$ 18.423,17 em vetor, procurar semanticamente algo parecido com dinheiro e pedir para um LLM adivinhar qual linha parecia mais convincente.
RAG brilha especialmente quando o conhecimento relevante é não estruturado ou semiestruturado: documentos, manuais, tickets, artigos, políticas, notas e bases textuais.
Uma arquitetura madura pode combinar:
SQL           → fatos estruturados
APIs          → ações e sistemas externos
Redis         → estado, cache, filas, streams, vetores
RAG           → conhecimento textual recuperável
LLM           → interpretação e geração
Workers       → trabalho assíncrono
O LLM deixa de ser o banco de dados, calculadora, fila, autorização e mecanismo de busca ao mesmo tempo.
Ele volta a fazer o que faz melhor.
O teste que importa: o sistema encontrou a evidência certa?
Projetos de RAG frequentemente avaliam apenas a resposta final.
Isso esconde onde o erro nasceu.
Uma avaliação mais útil separa pelo menos dois problemas:
Recuperação
Para perguntas cuja resposta sabemos estar em determinado documento, o sistema recuperou os chunks relevantes?
Podemos medir métricas como recall@k: entre os candidatos retornados nos primeiros K lugares, a evidência esperada apareceu?
Geração
Dado que a evidência correta foi fornecida, a resposta permaneceu sustentada por ela?
Essa separação é valiosa porque as correções são diferentes.
Se a passagem nunca chegou ao contexto, mexer no prompt do gerador é como reclamar com o cozinheiro porque o fornecedor entregou o ingrediente errado.
Se a passagem chegou corretamente e a resposta ainda inventou, então o problema está mais perto da geração.
A arquitetura fica mais simples de melhorar quando conseguimos medir as etapas separadamente.
Um pequeno exemplo mental de ponta a ponta
Vamos fechar o circuito com a pergunta do início:
“Qual é o prazo de cancelamento do contrato Enterprise?”
Antes da pergunta
O PDF politica-comercial-2026.pdf foi enviado.
Um worker extraiu o texto, preservou versao=2026-08, dividiu a seção de cancelamento em chunks, gerou embeddings e atualizou o índice.
Durante a pergunta
A aplicação identifica que o usuário pertence ao tenant 27 e pode consultar políticas comerciais internas.
A pergunta vira um embedding.
Uma busca híbrida recupera dez candidatos, filtrados por:
tenant_id = 27
status = vigente
classificacao <= interna
Um reranker coloca este trecho em primeiro:
O pedido de cancelamento do plano Enterprise deve ser
realizado com antecedência mínima de 30 dias.
O LLM recebe esse trecho e responde:
O plano Enterprise exige aviso prévio mínimo de 30 dias,
segundo a Política Comercial, versão 2026-08, página 17.
Parece simples na interface porque alguém fez a complexidade desaparecer por baixo dela.
Essa é uma das melhores definições de boa engenharia.
Quando a abstração cobra a conta
No começo deste artigo, a aplicação parecia um chat.
Agora conseguimos enxergar filas, confirmações, retries, workers, memória, persistência, parsing, chunks, embeddings, índices, filtros, grafos de vizinhança, recuperação, geração e observabilidade.
Isso pode soar como complexidade excessiva.
Mas a complexidade não nasceu porque decidimos desenhar caixas bonitas.
Ela já estava escondida no requisito:
“Quero que várias pessoas façam perguntas sobre milhares de documentos, com informação atualizada, permissão correta e resposta rápida.”
A arquitetura apenas tornou explícitas as partes do problema.
Workers existem porque certos trabalhos não pertencem ao tempo de vida de uma request.
Redis aparece porque aplicações precisam mover e manter dados com baixa latência, usando estruturas adequadas ao problema.
RAG existe porque conhecimento externo, atualizável e recuperável não é a mesma coisa que conhecimento comprimido nos parâmetros de um modelo.
E o LLM, apesar de ser a parte mais chamativa da história, pode ser apenas a última peça de uma cadeia muito maior.
Quando entendemos isso, a pergunta deixa de ser:
“Qual modelo de IA devo usar?”
E passa a ser:
“Que sistema preciso construir para que a informação certa chegue ao modelo certo, no momento certo, com as garantias certas?”
É uma pergunta menos mágica.
E muito mais útil em produção.
Leitura relacionada no ProjetoPlataforma
Se alguns termos como processo, thread, memória, cache, I/O e concorrência ainda parecem abstratos, o artigo Sob o Capô da Máquina: Uma Aula Sobre Arquitetura de Computadores e Sistemas Operacionais complementa esta leitura descendo mais uma camada: da aplicação até CPU, memória e sistema operacional.
FAQ
Celery, Redis e worker são a mesma coisa?
Não. Celery é o framework de tarefas distribuídas. Redis pode atuar como broker, armazenando as mensagens que aguardam consumo. O worker é o processo Celery que consome essas mensagens e coordena sua execução. Dentro de um worker ainda pode existir um pool com vários processos ou threads, dependendo da configuração de concorrência.
Preciso configurar result_backend para usar Celery?
Não. O broker é necessário para transportar tarefas; o result backend é opcional e serve para armazenar estado e retorno de tarefas quando isso é útil. Muitas aplicações mantêm o estado de negócio no banco principal e usam Celery apenas para disparar e executar o trabalho assíncrono.
Posso enviar um arquivo grande diretamente na tarefa?
Tecnicamente é possível serializar muita coisa, mas normalmente é uma má ideia. Mensagens grandes aumentam tráfego, memória e tempo de serialização do broker. Em pipelines de documentos, o padrão mais saudável é salvar o arquivo em storage e publicar apenas um identificador ou referência pequena para que o worker recupere o conteúdo.
Redis é um banco de dados ou apenas um cache?
Redis é um servidor de estruturas de dados em memória que pode atuar em vários papéis, incluindo banco de chave-valor, cache, mensageria, Streams e busca vetorial. Ele também oferece mecanismos de persistência como RDB e AOF. A escolha do papel depende do requisito da aplicação.
Redis substitui RabbitMQ ou Kafka?
Não existe substituição universal. Redis pode atuar como broker em frameworks como Celery e Streams resolve vários cenários de processamento de eventos, mas RabbitMQ, Kafka e outros sistemas possuem modelos, garantias e características operacionais diferentes. A comparação precisa partir do tipo de workload, retenção, throughput, ordenação e garantias necessárias.
RAG treina o modelo com meus documentos?
Não necessariamente. No padrão RAG clássico, os documentos são indexados externamente. Durante a consulta, trechos relevantes são recuperados e enviados ao modelo como contexto. Isso é diferente de alterar os pesos do modelo por fine-tuning ou treinamento adicional.
Embedding é a mesma coisa que token?
Não. Tokens são unidades usadas para representar a entrada textual de modelos. Embeddings são vetores numéricos que representam itens — como textos — em um espaço no qual proximidade pode capturar determinados tipos de similaridade.
Preciso de banco vetorial para fazer RAG?
Não obrigatoriamente. RAG descreve a combinação de recuperação e geração. A recuperação pode usar busca lexical, vetorial, híbrida, banco relacional, mecanismos especializados ou combinações. Bancos e índices vetoriais são comuns porque facilitam busca semântica em grandes coleções.
Todo pipeline de RAG precisa de workers?
Não. Em protótipos ou bases pequenas, a ingestão pode ocorrer diretamente. Workers se tornam especialmente úteis quando parsing, OCR, embeddings ou indexação são demorados, sujeitos a falhas, limitados por APIs externas ou precisam ser escalados independentemente do servidor HTTP.
Referências
- Redis — Data types. Documentação oficial sobre estruturas de dados disponíveis no Redis. https://redis.io/docs/latest/develop/data-types/
- Redis — Redis Streams. Documentação oficial sobre Streams, consumer groups e acknowledgment. https://redis.io/docs/latest/develop/data-types/streams/
- Redis — Pub/Sub. Documentação oficial sobre o modelo de publicação/assinatura e sua semântica de entrega. https://redis.io/docs/latest/develop/pubsub/
- Redis — Persistence. Documentação oficial sobre RDB, AOF e estratégias de persistência. https://redis.io/docs/latest/operate/oss_and_stack/management/persistence/
- Redis — SELECT / logical databases. Explica bancos lógicos como forma de namespacing dentro da mesma instância. https://redis.io/docs/latest/commands/select/
- Redis — Vector search concepts. Documentação oficial sobre campos vetoriais, KNN e busca com filtros. https://redis.io/docs/latest/develop/ai/search-and-query/vectors/
- Redis — Field and type options. Referência dos algoritmos
FLAT,HNSWeSVS-VAMANA. https://redis.io/docs/latest/develop/ai/search-and-query/indexing/field-and-type-options/ - Redis — RAG with Redis. Visão oficial de
retrieve,augmentegenerate, além de usos em RAG. https://redis.io/docs/latest/develop/get-started/rag/ - Celery — Introduction. Arquitetura de task queues, brokers, clients e workers. https://docs.celeryq.dev/en/latest/getting-started/introduction.html
- Celery — Using Redis. Redis como broker/backend, estruturas internas do transporte e
visibility timeout. https://docs.celeryq.dev/en/latest/getting-started/backends-and-brokers/redis.html - Celery — Tasks. Acknowledgments, idempotência, retries e comportamento de tarefas. https://docs.celeryq.dev/en/latest/userguide/tasks.html
- Celery — Concurrency. Pools
prefork, threads, eventlet, gevent e modelos de execução. https://docs.celeryq.dev/en/latest/userguide/concurrency/ - Celery — Optimizing. Prefetch, long-running tasks e ajustes de workers. https://docs.celeryq.dev/en/latest/userguide/optimizing.html
- Celery — Routing Tasks. Filas, rotas e direcionamento de tarefas a workers específicos. https://docs.celeryq.dev/en/latest/userguide/routing.html
- Lewis, P. et al. — Retrieval-Augmented Generation for Knowledge-Intensive NLP Tasks (2020). https://arxiv.org/abs/2005.11401
- Karpukhin, V. et al. — Dense Passage Retrieval for Open-Domain Question Answering (2020). https://arxiv.org/abs/2004.04906
- Gao, Y. et al. — Retrieval-Augmented Generation for Large Language Models: A Survey. https://arxiv.org/abs/2312.10997
- Wikipédia — Redis. Apoio histórico e visão introdutória. https://pt.wikipedia.org/wiki/Redis
- Wikipédia — Geração aumentada por recuperação. Visão introdutória do conceito RAG. https://pt.wikipedia.org/wiki/Gera%C3%A7%C3%A3o_aumentada_por_recupera%C3%A7%C3%A3o
Referências técnicas verificadas em 17/09/2026. A documentação oficial foi priorizada sobre fontes secundárias. As imagens deste artigo são diagramas originais elaborados para explicar os conceitos e não reproduções das ilustrações das fontes.