Um método para transformar conteúdo em entendimento, prática em competência e estudo em evidência.
Você termina um curso de vinte horas, sobe um ambiente, copia alguns comandos e vê tudo funcionando. Por alguns minutos, a sensação é ótima: agora eu sei essa tecnologia.
Duas semanas depois aparece um connection refused, um certificado TLS vencido, uma query que degrada o banco, um container que morre por falta de memória ou uma API que começa a responder 504. O tutorial acabou. A documentação parece maior do que antes. E aquilo que parecia conhecimento desaparece exatamente quando você precisa raciocinar.
Esse contraste explica boa parte da ansiedade de quem trabalha com tecnologia. O problema não é simplesmente a velocidade com que surgem ferramentas novas. O problema é tentar armazenar ferramentas como se a carreira fosse uma coleção de comandos.
A indústria realmente muda rápido. O Future of Jobs Report 2025, do World Economic Forum, mostra que empregadores esperam crescimento de importância em competências como IA e big data, redes e cibersegurança, letramento tecnológico, pensamento analítico e aprendizagem contínua até 2030. Mas repare no detalhe: o relatório fala principalmente em competências, não em decorar a versão atual de uma ferramenta. Essa distinção muda completamente a forma de estudar.
A pergunta deixa de ser “qual tecnologia preciso aprender esta semana?” e passa a ser outra:
que capacidade eu quero desenvolver, quais fundamentos sustentam essa capacidade e que evidência mostrará que eu realmente consigo usá-la?
Este artigo é sobre isso. Não existe método definitivo, fórmula que corta o tempo pela metade ou trilha universal capaz de garantir uma carreira. Existe algo mais útil: uma arquitetura de aprendizagem que reduz desperdício, fortalece fundamentos e transforma estudo em capacidade de resolver problemas.
O problema começa quando novidade vira currículo
A sensação de atraso em TI tem uma origem fácil de entender. Cada camada da computação cria novas abstrações e, sobre elas, nascem produtos, bibliotecas e serviços. Você abre uma rede social e encontra alguém dizendo que precisa aprender Kubernetes. Em seguida aparece uma nova plataforma de IA. Depois um banco vetorial. Depois serverless, eBPF, GitOps, uma linguagem nova e três frameworks que prometem simplificar os anteriores.
Se você tratar cada nome como um assunto independente, a quantidade de conteúdo realmente parece infinita.
Mas boa parte das tecnologias não nasce do zero. Elas reorganizam problemas antigos em abstrações novas. Um container não elimina processos, memória, sistema de arquivos e rede; ele coloca mecanismos de isolamento e controle ao redor deles. Um orquestrador não elimina servidores; ele cria uma camada de controle capaz de declarar estado desejado, observar estado atual e tentar reconciliar os dois. Um serviço de cache não elimina banco de dados; ele muda onde determinados dados são lidos, por quanto tempo permanecem válidos e quais inconsistências você aceita em troca de latência menor. Um sistema de RAG não “ensina” o modelo durante cada pergunta; ele adiciona recuperação de informação ao pipeline de inferência.
Essa é a primeira mudança de mentalidade: ferramentas são nós de uma árvore; fundamentos são as raízes.
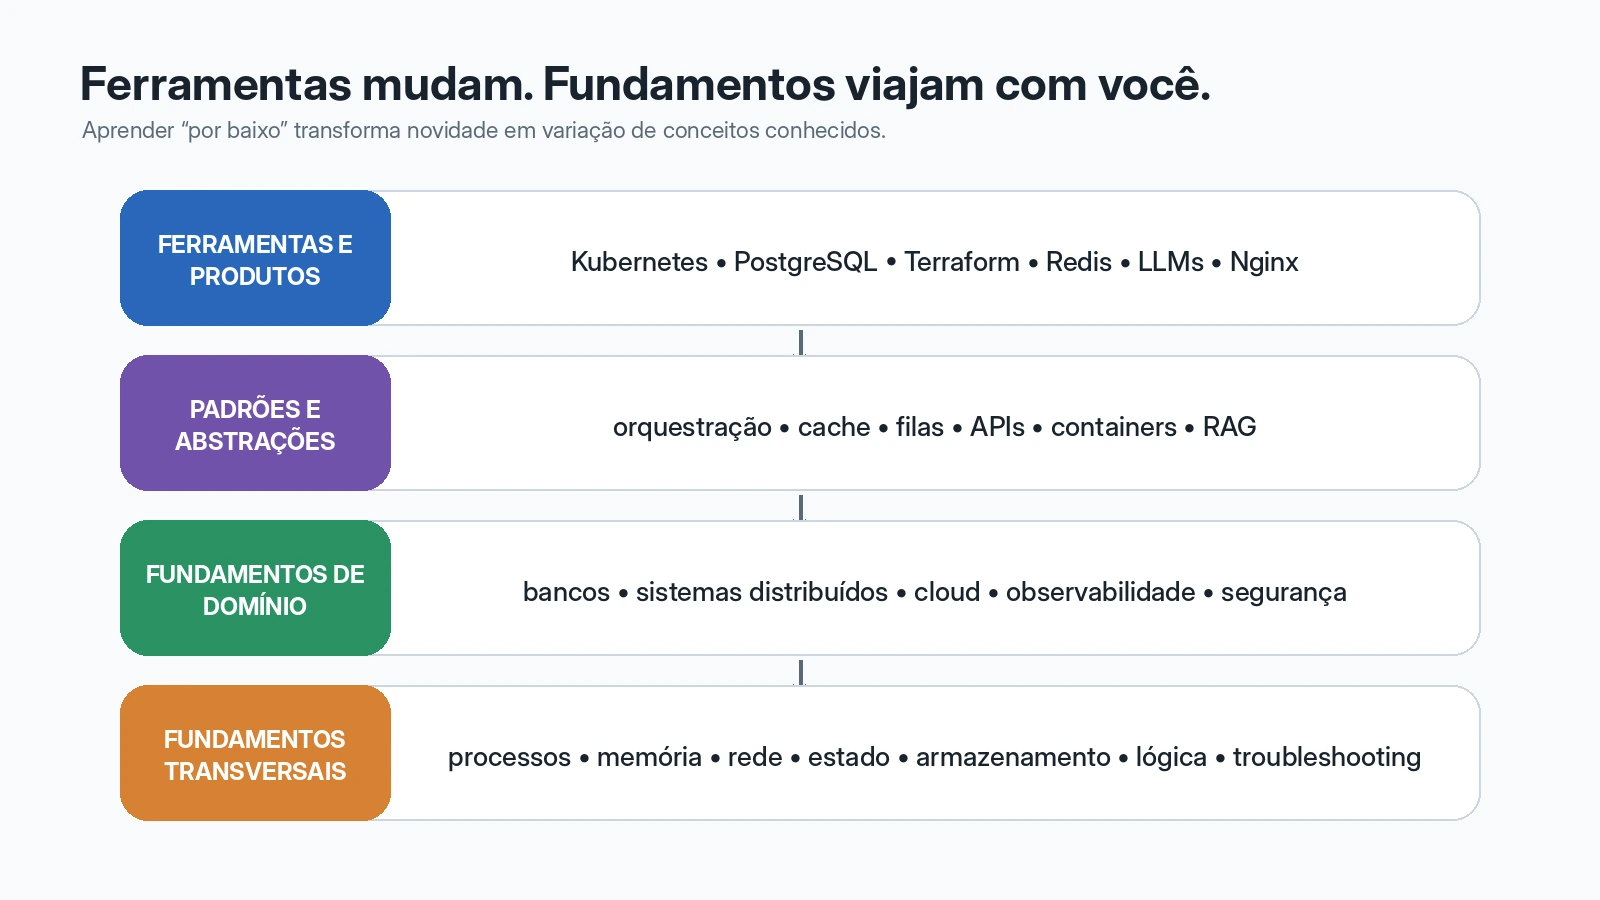
A formação em computação reconhece essa estrutura há décadas. O relatório Computing Curricula 2020, produzido em conjunto por ACM e IEEE Computer Society, não descreve um profissional apenas por linguagens ou produtos. Ele inclui áreas de conhecimento técnico e também capacidades como resolução de problemas e troubleshooting, pensamento analítico, comunicação, organização de tarefas, colaboração e habilidade de pesquisar e aprender de forma autônoma.
Isso não significa que ferramentas não importem. Elas importam muito, porque é com elas que o trabalho acontece. A diferença é a ordem mental: você aprende a ferramenta dentro de um sistema de conceitos, e não como se ela fosse o próprio sistema.
Um profissional que decorou docker run pode subir um container. Um profissional que entende processos, namespaces, cgroups, imagens em camadas, volumes e rede consegue explicar por que aquele container não enxerga o banco, por que consome mais memória do que deveria e por que gravar dados no filesystem efêmero foi uma decisão ruim.
É aí que o conhecimento começa a sobreviver à troca de ferramenta.
Fundamento não é sinônimo de algoritmo
O artigo anterior colocava Algoritmos e Estruturas de Dados como “a engrenagem principal de absolutamente tudo em TI”. A intenção era defender base técnica, mas a formulação é ampla demais.
Algoritmos e estruturas de dados são fundamentais, especialmente para desenvolvimento de software, análise de complexidade, processamento de dados e desenho de soluções. Mas um analista de infraestrutura pode passar o dia resolvendo DNS, roteamento, autenticação, armazenamento, processos e permissões sem implementar uma árvore balanceada. Um profissional de banco de dados precisa entender índices, páginas, buffers, planos de execução, transações e locks. Em segurança, identidade, criptografia, protocolos, modelos de ameaça e controle de acesso podem ser mais diretamente relevantes. Em suporte e sustentação, sistema operacional, rede e observabilidade muitas vezes explicam o incidente antes que o código da aplicação entre na investigação.
Portanto, em vez de procurar o fundamento, pense em camadas de fundamento.
Na base estão ideias que atravessam quase toda a área: representação de informação, lógica, sistemas operacionais, redes, armazenamento, segurança, automação e capacidade de decompor problemas. Acima delas aparecem fundamentos mais específicos: bancos de dados, sistemas distribuídos, desenvolvimento, cloud, observabilidade, engenharia de dados, IA, governança, gestão de serviços. Só então entram produtos e implementações concretas.
Essa estrutura explica por que estudar “por baixo” costuma gerar reutilização. Quem entende TCP, DNS, HTTP, TLS, timeout e retry transporta esse conhecimento entre Nginx, APIs, load balancers, service meshes, gateways e serviços de nuvem. Quem entende processo, memória, filesystem e permissões carrega esse modelo mental entre Linux, Docker, Kubernetes, máquinas virtuais e plataformas gerenciadas.
Para quem deseja aprofundar justamente essa camada, o artigo Sob o Capô da Máquina: Uma Aula Sobre Arquitetura de Computadores e Sistemas Operacionais segue a mesma lógica: a abstração ajuda até o dia em que você precisa explicar o que está acontecendo abaixo dela.
Um roadmap é um mapa, não um currículo e muito menos uma garantia
Ferramentas como o roadmap.sh são úteis porque resolvem um problema real: dão uma visão de dependências e ajudam a enxergar o território antes de você começar. O próprio projeto se descreve como uma iniciativa comunitária com roadmaps, planos de estudo e recursos criados e revisados pela comunidade e por especialistas. Isso é diferente de ser um padrão oficial da indústria.
A diferença parece pequena, mas é importante.
Um mapa mostra caminhos possíveis. Ele não conhece sua experiência anterior, o ambiente onde você trabalha, o tipo de problema que precisa resolver nem o nível de profundidade exigido pela sua função. Se você seguir cada caixa de um roadmap como uma lista obrigatória, pode trocar a ansiedade de “não sei o que estudar” pela ansiedade de “tenho 143 itens para completar”.
A melhor forma de usar um mapa é de trás para frente.
Imagine que seu objetivo seja “operar uma API em produção”. Isso não é uma ferramenta; é uma capacidade. Para fazê-lo, você provavelmente precisará compreender o ciclo de uma request, DNS, TLS, autenticação, logs, métricas, timeout, retry, banco de dados, deploy, rollback e algum mecanismo de execução — máquina virtual, container, plataforma gerenciada ou outra abstração. Agora a lista possui causalidade: cada item existe porque sustenta uma tarefa.
Essa lógica aparece de forma explícita no NICE Framework do NIST para cibersegurança. O framework descreve trabalho através de tarefas, conhecimentos e habilidades. A ideia é poderosa mesmo fora da segurança: não começar pelo nome do curso, mas pelo trabalho que alguém precisa ser capaz de executar.
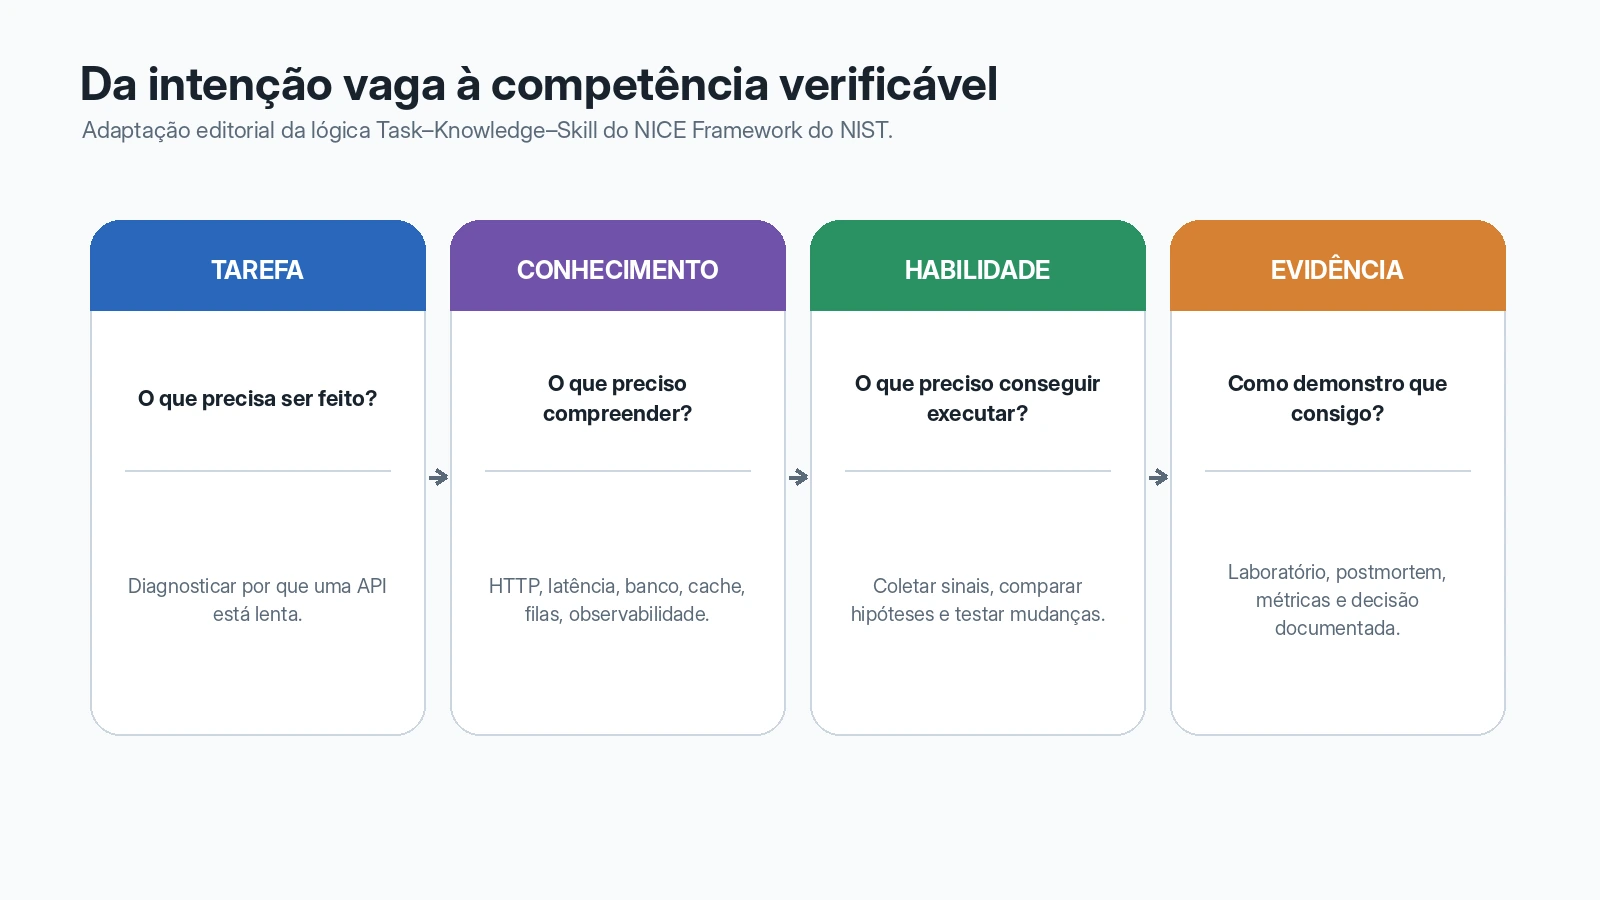
Para estudar qualquer área de TI, você pode montar a mesma cadeia:
tarefa real → conhecimentos necessários → habilidades praticáveis → evidência de execução.
Quer aprender banco de dados? “Conhecer PostgreSQL” é abstrato. “Diagnosticar por que uma consulta ficou lenta após o crescimento da tabela” é uma tarefa. Ela exige entender índice, seletividade, estatísticas, plano de execução, cache, I/O e, dependendo do caso, concorrência. A evidência pode ser um laboratório documentado comparando planos antes e depois de uma alteração.
Quer aprender redes? “Estudar TCP/IP” ainda é amplo. “Explicar e diagnosticar por que uma aplicação resolve o DNS, abre conexão TCP, mas falha no handshake TLS” cria um recorte verificável. A partir dele, você aprende os conceitos porque precisa deles para explicar um comportamento observável.
O estudo fica menos parecido com acumulação de conteúdo e mais parecido com engenharia.
Familiaridade parece conhecimento até você fechar a aba
Existe um fenômeno traiçoeiro no estudo: acompanhar uma explicação produz sensação de fluidez. Você lê um texto, assiste a uma aula ou vê alguém executar um comando e tudo parece fazer sentido. Como cada passo chega logo depois do anterior, seu cérebro reconhece a sequência. Esse reconhecimento, porém, não é a mesma coisa que conseguir reconstruir o raciocínio sozinho.
A pesquisa em ciência da aprendizagem ajuda a colocar isso em termos mais precisos. Em uma revisão ampla publicada em Psychological Science in the Public Interest, John Dunlosky e colegas avaliaram diferentes técnicas de estudo. Practice testing — tentar recuperar a informação sem olhar a resposta — e prática distribuída ao longo do tempo receberam avaliação de alta utilidade; releitura e destaque, embora possam ter usos pontuais, não demonstraram a mesma consistência para aprendizagem durável.
Karpicke e Roediger mostraram em um estudo clássico publicado na Science que a prática de recuperação tem papel central na retenção de longo prazo. O ponto não é transformar todo assunto em prova escolar. É forçar o cérebro a produzir a resposta, em vez de apenas reconhecê-la quando ela está na tela.
Em TI, isso muda pequenos hábitos.
Depois de ler sobre DNS, feche a documentação e desenhe de memória o caminho entre o navegador e o resolvedor. Depois de estudar Docker, tente explicar sem consulta o que diferencia imagem, container, volume e rede. Depois de aprender uma query, reconstrua o raciocínio que levou ao índice escolhido. Depois de um incidente, escreva a sequência causal antes de reler o postmortem.
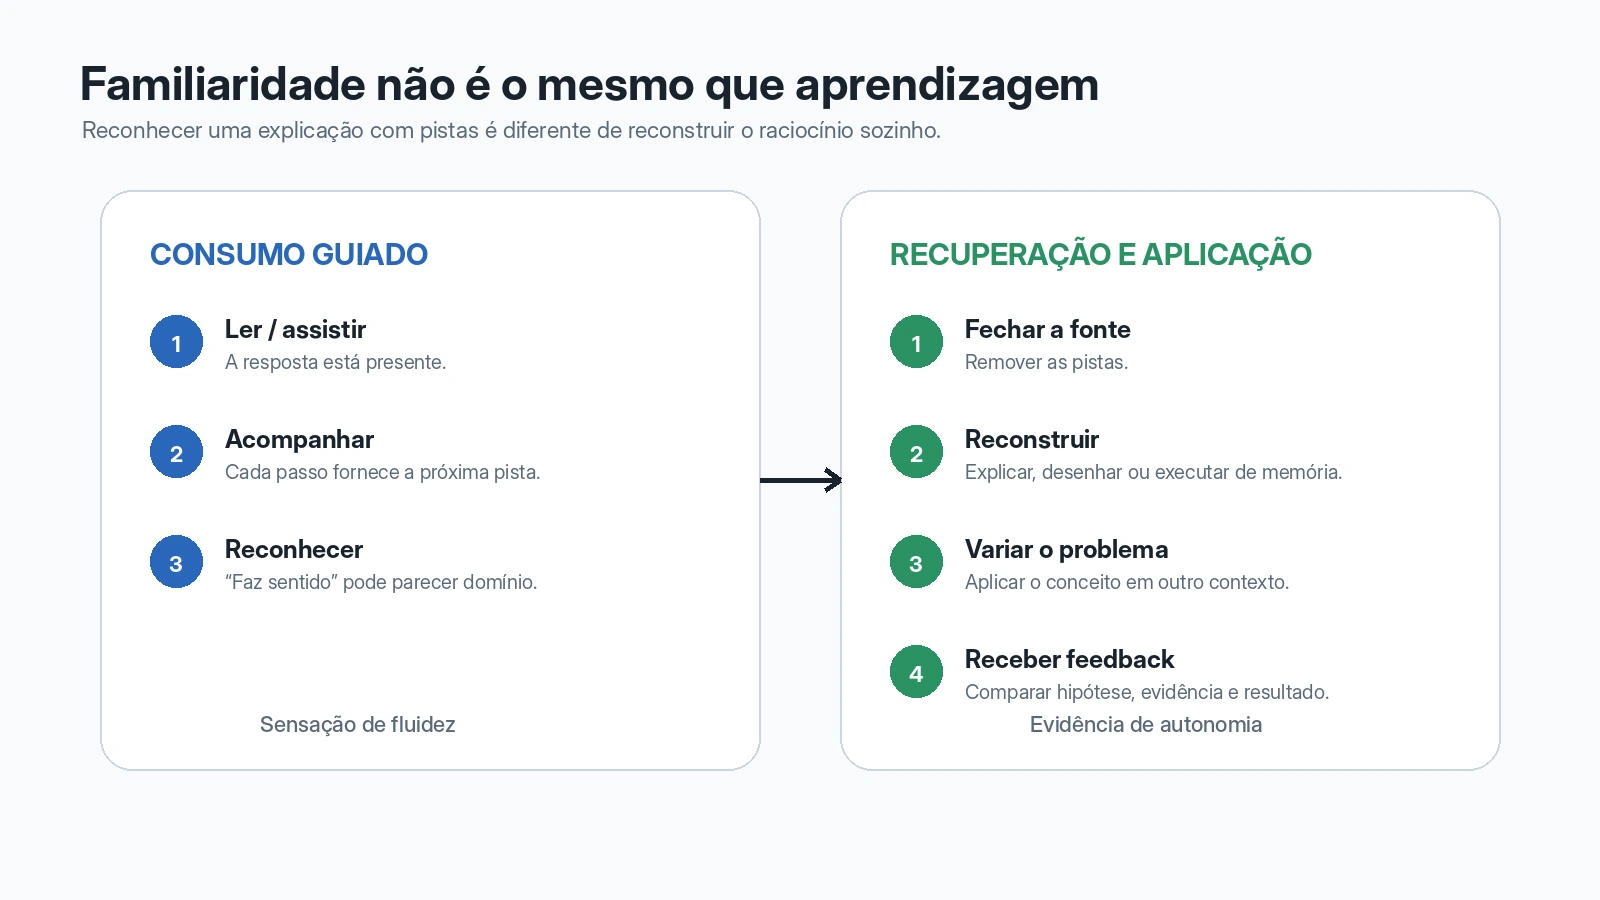
Isso não torna vídeo, documentação ou leitura inúteis. Seria outro exagero. Conteúdo expositivo é excelente para adquirir o primeiro modelo mental. O problema começa quando aquisição é confundida com domínio.
Uma analogia ajuda. Ver um mecânico desmontar um motor pode ensinar nomes de peças, ordem de montagem e relação entre componentes. Mas você só descobre o que realmente entendeu quando recebe uma falha, precisa formular hipóteses e não há alguém indicando qual parafuso soltar. O retorno ao conceito técnico é direto: exposição fornece pistas; recuperação e resolução sem pistas revelam se o modelo mental consegue operar sozinho.
A memória não falha porque você é ruim; ela faz exatamente o que memórias fazem
Outro erro comum é estudar um assunto intensamente por um fim de semana e interpretar a sensação de domínio imediato como permanência. O conhecimento novo compete com interferência, tempo e outras tarefas. Sem revisita, parte dele se torna mais difícil de recuperar.
A pesquisa sobre spacing effect — o efeito de distribuir sessões de estudo — é antiga e extensa. Estudos e revisões modernas mostram que, em muitos contextos, distribuir o contato com o material pode melhorar retenção de longo prazo quando comparado a concentrar toda a prática em uma única sessão. Isso não significa que exista um intervalo universal do tipo “revise exatamente em 1, 7 e 30 dias”. O espaçamento adequado depende do material, do grau de domínio, do intervalo até a futura necessidade e do tipo de tarefa.
A aplicação prática em TI é mais simples do que parece. Você não precisa criar centenas de flashcards sobre comandos. Pode revisitar o mesmo modelo em contextos diferentes.
Na primeira semana, você aprende timeout em uma API. Depois, encontra timeout entre aplicação e banco. Mais tarde, configura timeout em um reverse proxy. Em seguida, investiga um consumidor de fila que fica preso esperando um serviço externo. O conceito reaparece, mas o contexto muda. Essa variação força discriminação: você deixa de associar “timeout” a uma tela específica e passa a reconhecê-lo como decisão de engenharia sobre quanto tempo um componente aceita esperar por outro.
Essa é uma forma particularmente poderosa de prática distribuída para profissionais: o fundamento volta, só que vestido de outro problema.
O laboratório que ensina começa onde o tutorial termina
Tutoriais costumam ser desenhados para reduzir atrito. Eles entregam versão compatível, comando correto, porta certa, arquivo no lugar esperado e um resultado previsível. Isso é ótimo para a primeira execução. Também é exatamente o motivo pelo qual um tutorial, sozinho, ensina pouco sobre diagnóstico.
Produção não entrega o caminho feliz.
O certificado expira. A credencial possui permissão parcial. O DNS resolve para um endereço antigo. O filesystem fica cheio. O processo recebe OOM Kill. A query funcionava com dez mil linhas e agora precisa percorrer cinquenta milhões. O retry transforma uma falha pequena em tempestade de requisições. O cache mantém um dado obsoleto. Um deploy altera o contrato e um consumidor antigo quebra.
Por isso, depois que o laboratório funciona, a etapa seguinte deveria ser quebrá-lo de propósito.
Pegue um ambiente simples com uma API, um banco e um reverse proxy. Primeiro faça tudo funcionar. Depois altere a porta do banco sem atualizar a aplicação. Observe o erro. Corrija. Em seguida, remova a resolução de nome. Depois troque permissões do volume. Limite memória. Gere carga. Mude um certificado. Introduza latência. Em cada falha, não procure imediatamente a solução. Recolha sinais.
A investigação pode seguir um loop simples:
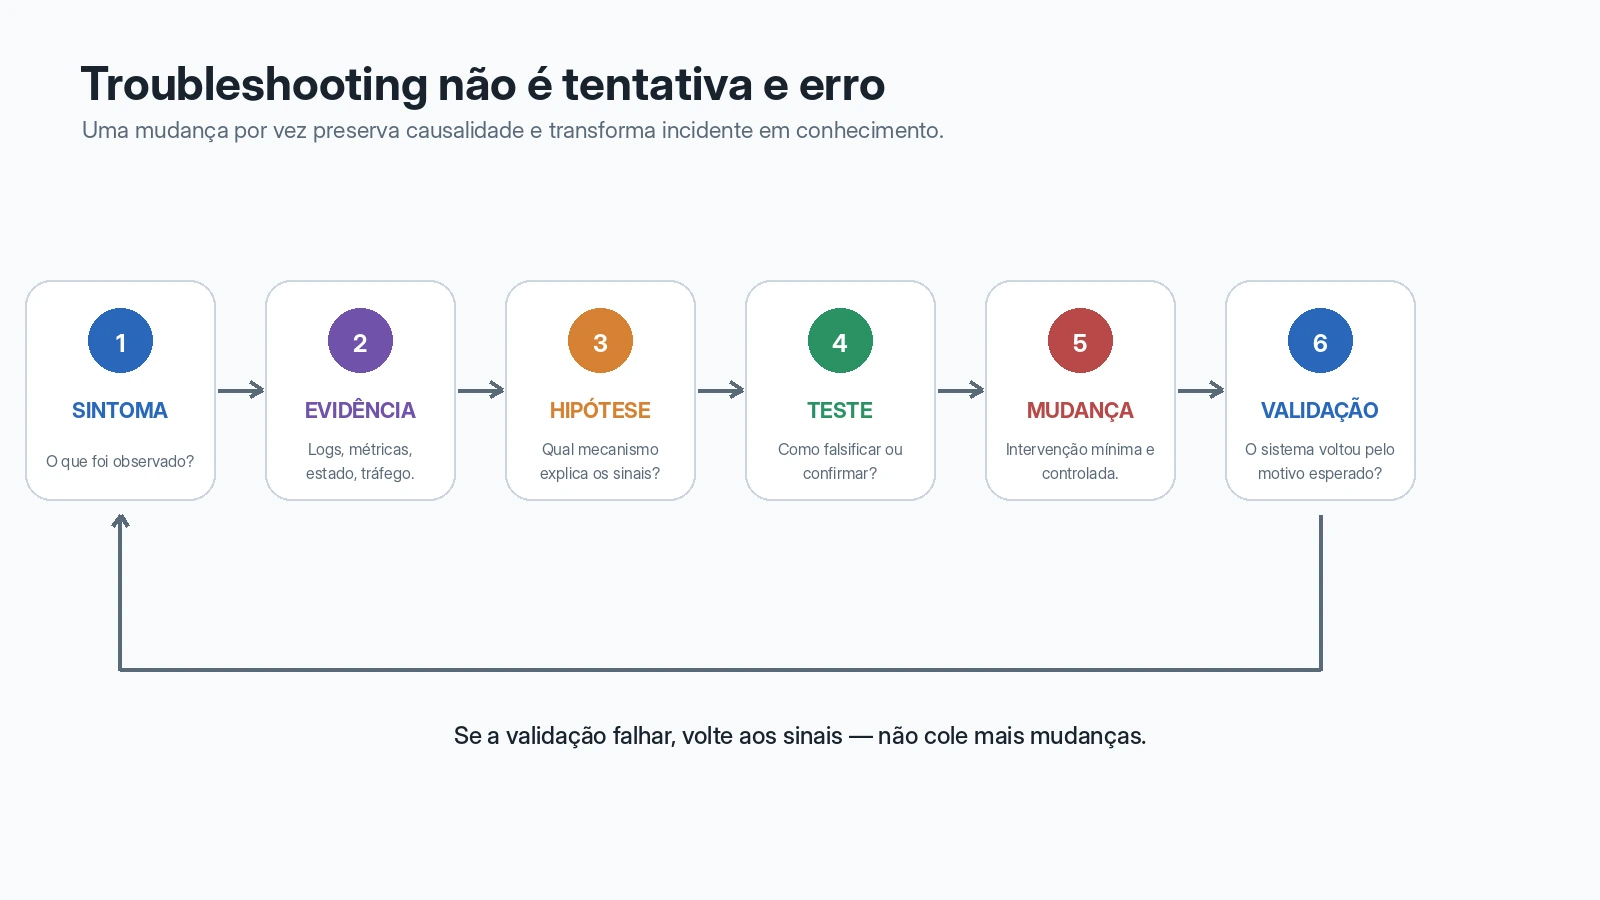
sintoma → evidência → hipótese → teste → mudança → validação.
Esse fluxo parece óbvio, mas ele impede um hábito destrutivo: alterar cinco coisas ao mesmo tempo até o sistema “voltar”. Quando isso acontece, você recupera o serviço, mas não necessariamente aprende a causa.
Veja um exemplo. Sua aplicação em container não consegue acessar o PostgreSQL.
O iniciante tende a perguntar: “qual comando resolve?”. O estudo orientado a diagnóstico faz perguntas melhores. O processo do banco está ouvindo? Em qual interface e porta? O nome resolve dentro do namespace de rede do container? Existe rota? A conexão TCP abre? A autenticação é recusada depois da conexão? O segredo está correto? O banco aceita aquela origem? O log do servidor confirma tentativa? A aplicação está usando localhost, esquecendo que localhost dentro do container aponta para o próprio ambiente isolado?
Uma única falha pode ensinar rede, processos, configuração, observabilidade e isolamento de containers ao mesmo tempo. É justamente esse tipo de cruzamento que cria conhecimento transferível.
Prática deliberada: menos slogan, mais recorte do que está fraco
O termo “prática deliberada” ficou popular porque parece confirmar uma ideia atraente: basta praticar muito e a excelência virá. A literatura é mais cuidadosa.
O trabalho de K. Anders Ericsson enfatizou atividades desenhadas para melhorar aspectos específicos do desempenho, com repetição, avaliação e feedback. Pesquisas posteriores discutiram o quanto o volume de prática, sozinho, explica diferenças entre especialistas e mostraram que expertise é multifatorial. A lição útil para TI não é contar horas nem perseguir uma regra mítica de dez mil horas. É parar de repetir apenas aquilo que você já executa confortavelmente.
Se você já sabe subir uma VM, subir mais cinquenta VMs seguindo o mesmo roteiro aumenta experiência operacional, mas pode acrescentar pouco ao seu modelo mental. Talvez sua fraqueza esteja em segurança de rede, automação, observabilidade ou recuperação de desastre. A prática que produz crescimento precisa atingir o gargalo.
Para um desenvolvedor, o gargalo pode ser ler plano de execução. Para alguém de infraestrutura, pode ser diagnosticar rede sem depender de tentativa e erro. Para suporte, pode ser separar sintoma de causa. Para segurança, pode ser construir uma hipótese de ameaça antes de escolher uma ferramenta. Para um analista de dados, pode ser explicar por que determinada métrica não responde à pergunta de negócio.
Feedback também precisa ser específico. “Está bom” quase não informa nada. “Seu script funciona, mas não é idempotente; na segunda execução ele duplica o estado” aponta um defeito que pode ser corrigido e testado. “A arquitetura escala” é vago. “O serviço é stateless, mas o banco permanece como gargalo único e o connection pool limita concorrência” cria uma discussão verificável.
A máquina oferece parte desse feedback por logs, testes e métricas. Revisão por outra pessoa adiciona o que a máquina não vê facilmente: legibilidade, hipótese errada, risco operacional, escolha arquitetural, clareza de comunicação e trade-offs.
O ciclo de aprendizagem técnica que uso como referência
Quando juntamos fundamento, recuperação, prática, feedback e revisão, o estudo deixa de ser uma fila infinita de cursos. Ele vira um ciclo.
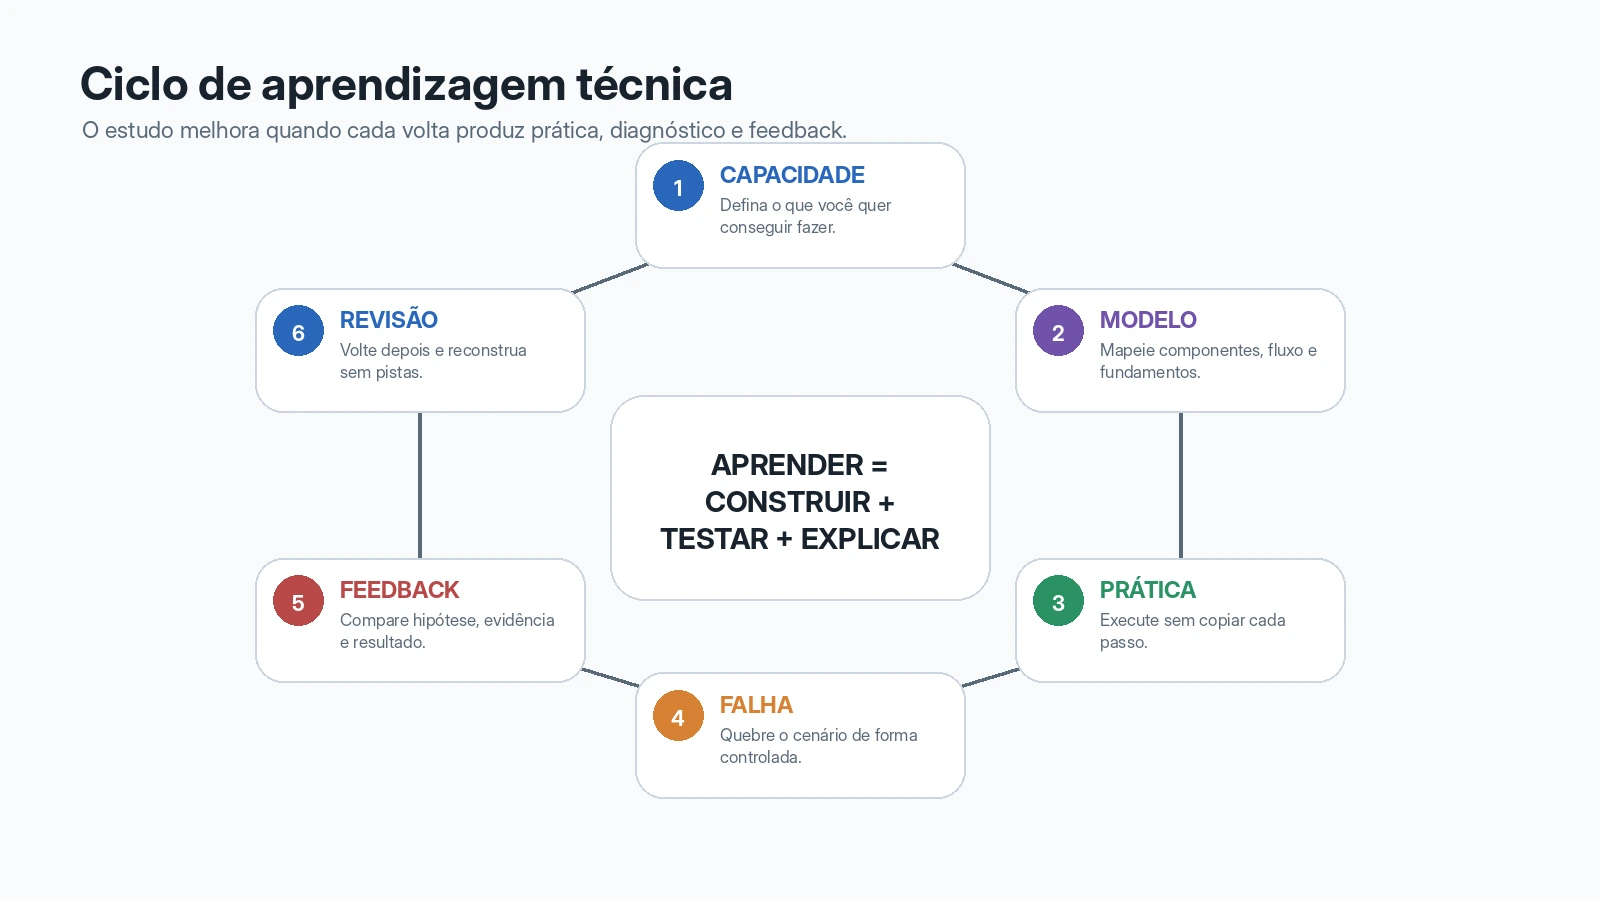
Comece por uma capacidade observável
“Aprender Kubernetes” é amplo demais. “Entender por que um Pod reinicia, identificar a evidência e corrigir a causa” é observável. “Aprender segurança” é um continente. “Modelar autenticação de uma API e explicar como token, escopo, expiração e autorização se relacionam” já pode ser exercitado.
A capacidade define a fronteira do estudo. Sem essa fronteira, qualquer link parece importante.
Mapeie apenas os pré-requisitos que explicam o problema
Você não precisa dominar toda a ciência da computação antes de começar. Precisa identificar quais lacunas impedem o próximo passo.
Ao estudar Kubernetes, por exemplo, talvez precise voltar a processos, rede, DNS, volumes, containers e arquivos YAML. Ao estudar banco de dados, talvez seja necessário revisar estruturas de dados, armazenamento, transações ou SQL. O retorno ao fundamento acontece sob demanda, mas não de forma superficial.
Esse detalhe evita dois extremos: estudar ferramenta sem base e passar anos estudando base sem construir nada.
Construa um modelo antes de decorar comandos
Antes de executar, desenhe os componentes e o fluxo. Quem chama quem? Onde o estado vive? Qual componente decide? O que pode falhar? Qual é a entrada? Qual é a saída? Onde existe fila? Onde existe persistência? Quais limites de confiança existem?
Quando o diagrama estiver claro, os comandos ganham lugar dentro de uma arquitetura.
Execute sem copiar o caminho inteiro
Use documentação, mas reduza dependência progressivamente. Faça uma primeira execução guiada. Depois reconstrua partes sem consulta. Em seguida, mude o cenário. Se o laboratório só funciona quando o tutorial está aberto ao lado, o tutorial ainda é parte do sistema.
Quebre, diagnostique e explique
Introduza falhas controladas. Colete evidências antes de alterar. Registre hipótese. Faça uma mudança por vez. Valide. Ao terminar, explique o que aconteceu como se estivesse entregando o caso para outro profissional continuar.
Essa explicação é uma segunda forma de teste. Frases vagas denunciam lacunas. Quando você precisa escrever “o serviço ficou indisponível porque…”, a causalidade é obrigada a aparecer.
Volte depois
Dias ou semanas depois, refaça uma parte sem consultar seu material. Se não lembrar, isso não significa que o estudo fracassou. Significa que você encontrou o ponto exato que precisa ser recuperado novamente.
Esse ciclo é menos glamouroso do que “domine X em sete dias”. Também é muito mais parecido com a forma como competência técnica amadurece no trabalho real.
Como aplicar o método em áreas diferentes
Um bom método precisa sobreviver à troca de domínio. Caso contrário, ele é apenas um tutorial mais abstrato.
Em redes, construa um pequeno serviço e observe o caminho completo: resolução DNS, conexão, TLS, HTTP e resposta. Depois provoque falhas em cada camada. Não tente memorizar o modelo OSI como uma poesia; use camadas para localizar evidências.
Em Linux, crie processos, acompanhe CPU e memória, manipule permissões, monte filesystems, esgote espaço em um ambiente descartável, acompanhe logs, derrube serviços e recupere-os. top, ps, ss, lsof, journalctl, df e du deixam de ser comandos isolados quando cada um responde a uma pergunta de diagnóstico.
Em bancos de dados, comece com uma consulta pequena, aumente volume, observe o plano, crie e remova índices, provoque contenção, abra duas transações e veja como locks aparecem. Uma aula sobre ACID se torna muito mais concreta quando uma transação bloqueada está diante de você.
Em APIs, não pare no 200 OK. Teste 400, 401, 403, 404, 409, 429 e 5xx quando fizer sentido. Adicione timeout. Faça retry. Descubra por que repetir uma operação não idempotente pode duplicar efeito. Quebre compatibilidade de contrato e observe consumidores.
Em cloud e containers, não estude apenas criação de recurso. Estude limite, falha e recuperação: health check, consumo de memória, permissões, rede, segredo, persistência, escalonamento, rollback e custo. A abstração da nuvem continua executando em computadores reais, com CPU, memória, rede e armazenamento reais.
Em IA generativa, vá além do prompt. Observe tokens, janela de contexto, custo, latência, chamadas de ferramentas, autorização, recuperação de dados, avaliação e tratamento de erro. Um protótipo que responde perguntas é diferente de um sistema que acessa dados corporativos e executa ações. No artigo A IA bateu no teto? Por dentro dos LLMs, agentes e da corrida bilionária por inteligência, aprofundo justamente essa diferença entre modelo e sistema.
A estrutura permanece: escolha uma capacidade, encontre fundamentos, construa, quebre, diagnostique, explique e revisite.
A IA pode acelerar o estudo — e também esconder que você não aprendeu
Em 2026, qualquer método de estudo para TI que ignore IA já nasce incompleto. Modelos podem explicar conceitos, gerar exercícios, revisar configurações, criar cenários de falha, simular entrevistas técnicas, comparar hipóteses e ajudar a navegar documentação. Usados dessa forma, funcionam como uma camada de scaffolding: suporte temporário enquanto você constrói autonomia.
O risco aparece quando a ferramenta resolve exatamente a parte que deveria exercitar seu raciocínio.
Um estudo randomizado com 275 estudantes, publicado em Computers and Education: Artificial Intelligence em 2026, comparou estudantes de programação com suporte de um tutor de IA baseado em dicas, ChatGPT com assistência irrestrita e recursos tradicionais da web. Os grupos com IA obtiveram desempenho melhor na tarefa, mas isso não se converteu em ganhos maiores nos testes de conhecimento e compreensão de código. Os autores descrevem uma dissociação importante entre performance durante a execução e aprendizagem.
Esse resultado ajuda a formular uma regra prática: use IA para aumentar a qualidade do esforço, não para eliminar o esforço cognitivo que você precisa aprender a fazer.
Se estiver estudando troubleshooting, em vez de colar o erro e pedir “me dê a solução”, peça: “faça perguntas que me ajudem a reduzir o espaço de hipóteses sem revelar a resposta”. Se estiver estudando arquitetura, apresente sua solução primeiro e peça críticas. Se estiver aprendendo SQL, escreva a query antes e peça para o modelo mostrar riscos e alternativas. Se estiver revisando um incidente, produza sua linha do tempo e depois use a IA como revisor adversarial.
A diferença é sutil. Em um caso, a IA substitui o raciocínio. No outro, ela aumenta a quantidade e a velocidade de feedback sobre o seu raciocínio.
Certificação, curso e documentação cumprem papéis diferentes
Também existe confusão sobre recursos de estudo. Curso, certificação, documentação, livro, laboratório e comunidade não competem necessariamente entre si. Eles resolvem problemas diferentes.
Um curso oferece sequência e reduz o custo de entrada. É útil quando você ainda não sabe separar o essencial do acessório. A documentação oficial é a referência mais próxima do comportamento suportado pelo produto, mas nem sempre foi escrita para ensinar fundamentos do zero. Um livro técnico pode aprofundar modelos e decisões com mais continuidade do que páginas fragmentadas. Uma certificação cria uma ementa e um mecanismo de avaliação, mas passar na prova não demonstra automaticamente experiência operacional. Um laboratório transforma conceito em comportamento observável. Uma comunidade expõe casos que a documentação não antecipou, embora respostas devam ser verificadas.
O erro é exigir de um recurso aquilo que ele não promete.
Você pode usar um curso para adquirir o mapa, documentação para validar detalhes, laboratório para praticar, revisão por pares para receber feedback e um projeto real para integrar tudo. Quando as peças têm função clara, você para de procurar “o melhor curso” como se um único produto pudesse entregar entendimento, prática, contexto, feedback e experiência.
O mercado não compra quantidade de estudo; compra capacidade de produzir resultado
Aqui a discussão volta para carreira.
O World Economic Forum não afirma que uma ferramenta específica “garantirá emprego”. O que seus dados apontam é uma expectativa de mudança significativa de competências até 2030, com destaque para IA e big data, redes e cibersegurança, letramento tecnológico, pensamento analítico, criatividade, resiliência e aprendizagem contínua. Para empresas de serviços de informação e tecnologia, o relatório também registra forte expectativa de adoção de IA e tecnologias de processamento de informação.
O relatório reúne a perspectiva de mais de mil empregadores, que representam mais de 14 milhões de trabalhadores em 55 economias. Isso dá escala à pesquisa, mas também define seu limite: estamos olhando principalmente para expectativas declaradas por empregadores, não para um censo de vagas, salários ou contratações futuras.
Por isso, os resultados devem ser lidos como sinal de direção, não como ranking salarial universal. Mercado depende de país, senioridade, setor, conjuntura econômica, idioma, tipo de empresa e oferta local. Dizer simplesmente “estas são as três áreas que mais pagam” transforma um fenômeno complexo em propaganda.
Existe, porém, uma consequência mais estável: quanto mais ferramentas automatizam tarefas repetitivas, maior é o valor relativo de quem consegue definir o problema, verificar a saída, integrar sistemas, diagnosticar falhas, avaliar risco e tomar decisões técnicas com contexto.
O NIST, ao organizar funções de cibersegurança em tarefas, conhecimentos e habilidades, expressa a mesma ideia por outro caminho. A competência profissional aparece quando conhecimento é conectado a trabalho executável.
É por isso que portfólio técnico não deveria ser coleção de telas bonitas nem repositórios copiados de curso. Uma boa evidência mostra processo de engenharia: o problema, as restrições, a arquitetura, a decisão, o teste, a falha encontrada, o que você mudou e como validou.
Se quiser aprofundar esse ponto, o artigo Além do Currículo: A Importância de Construir um Portfólio de Evidências complementa este método: depois de aprender, transforme o trabalho em evidência verificável.
Um projeto de estudo precisa ter saída, não apenas entrada
Há uma pergunta simples que melhora qualquer plano de estudo: o que existirá ao final que não existia no início?
“Assistir 12 horas de aula” descreve entrada. “Ler três livros” descreve entrada. “Fazer uma certificação” descreve uma avaliação, mas ainda não diz o que você consegue construir ou diagnosticar.
Saídas são diferentes.
Um diagrama que explica o fluxo de uma request. Um laboratório reproduzível. Um README que permite a outra pessoa executar o ambiente. Um postmortem de uma falha simulada. Um script idempotente. Um dashboard com métricas e hipóteses. Um ADR explicando por que uma decisão foi tomada. Um conjunto de testes que captura um bug. Um artigo técnico que parte de evidências e chega a uma conclusão.
Esses artefatos têm duas funções. Primeiro, forçam organização mental: é difícil documentar bem aquilo que você ainda não entendeu. Segundo, permitem que outra pessoa avalie parte do seu raciocínio.
Isso reduz a distância entre “estudei” e “consigo demonstrar”.
Um exemplo completo: aprender Docker sem transformar Docker no objetivo
Vamos concretizar o método.
Suponha que você queira aprender Docker. O plano superficial seria assistir a uma playlist, copiar Dockerfile, executar docker build, docker run e subir um docker compose.
Funciona. Mas ainda não sabemos se você compreendeu o que está acontecendo.
O plano orientado a capacidade começa com um objetivo: empacotar uma aplicação com dependências reproduzíveis, conectá-la a um banco, persistir dados e diagnosticar falhas de execução.
Agora os conceitos aparecem por necessidade. Imagem responde por que a aplicação pode ser distribuída de forma reproduzível. Container responde como um processo é executado com isolamento. Rede responde como os serviços se encontram. Volume responde onde o estado persistente deve viver. Variáveis e secrets tratam configuração. Health check ajuda a diferenciar processo existente de serviço realmente saudável. Limites de recurso introduzem CPU, memória e comportamento sob pressão.
Depois do caminho feliz, quebre o ambiente.
Use localhost de forma errada e descubra o escopo de rede. Remova permissão do volume. Mude uma variável. Derrube o banco. Faça a aplicação iniciar antes da dependência estar pronta. Gere consumo de memória. Observe docker inspect, logs, status de processo e eventos. Antes de cada correção, escreva sua hipótese.
Por fim, feche a documentação e reconstrua o desenho: host, daemon/runtime, imagem, container, rede, volume, processos e portas. Explique por que o banco não deve gravar dados importantes apenas na camada gravável efêmera do container.
Agora Docker deixou de ser uma coleção de comandos. Virou um caso aplicado de processos, isolamento, rede, filesystem e configuração.
Quando surgir outra tecnologia de container, parte relevante do conhecimento viaja com você.
Quando a abstração cobra seu preço, fundamentos viram velocidade
Existe uma ironia na ideia de “acelerar a carreira”. Tentar acelerar pulando fundamentos frequentemente produz o efeito contrário.
Enquanto tudo funciona, a pessoa que decorou o caminho feliz pode parecer mais rápida. Ela instala antes, copia a configuração antes e chega ao resultado visível antes. A diferença surge na primeira variação relevante: uma versão muda, o ambiente não é idêntico, aparece uma restrição de segurança, a escala cresce ou um componente falha.
Nesse momento, quem possui modelo mental não precisa lembrar a resposta exata. Precisa localizar o problema.
Pense em uma biblioteca. Decorar onde um livro está hoje pode ser mais rápido do que entender o sistema de catalogação. Mas se a biblioteca reorganizar as estantes, sua memória de posição perde valor. Quem entende o catálogo ainda consegue encontrar o livro. Voltando à TI: sintaxe e interface mudam; modelos de processo, rede, estado, concorrência, consistência, autenticação, observabilidade e falha continuam oferecendo coordenadas.
É por isso que fundamentos não tornam a carreira “mais teórica”. Quando escolhidos de acordo com os problemas que você realmente precisa resolver, eles reduzem o tempo gasto em tentativa e erro.
O que muda depois que você aprende a aprender tecnologia
No início deste artigo, o problema parecia ser excesso de novidades.
Depois de atravessar as camadas, a imagem muda. A quantidade de ferramentas continua enorme. A velocidade do mercado continua desconfortável. IA, cloud, segurança e dados continuam evoluindo. Nada disso desapareceu.
O que desaparece é a obrigação de tratar cada novidade como um novo começo.
Você passa a perguntar: que problema esta tecnologia tenta resolver? Que abstração ela cria? Quais fundamentos ela reutiliza? Onde guarda estado? Como se comunica? O que acontece quando falha? Como observo seu comportamento? Que trade-off ela introduz?
Essas perguntas são mais lentas no primeiro contato e mais rápidas no longo prazo.
O objetivo não é saber tudo. Também não é aprender “qualquer coisa em tempo recorde”. É construir uma base que permita aprender com menos desperdício e esquecer sem pânico, porque você sabe reconstruir o raciocínio quando precisar.
No fim, a vantagem mais durável em TI não está em acompanhar cada ferramenta no dia em que ela aparece. Está em reconhecer padrões, investigar o que acontece por baixo da abstração e transformar informação em capacidade verificável.
Ferramentas mudam. A habilidade de fazer boas perguntas sobre elas continua.
Referências e fontes
Ciência da aprendizagem e expertise
- DUNLOSKY, John; RAWSON, Katherine A.; MARSH, Elizabeth J.; NATHAN, Mitchell J.; WILLINGHAM, Daniel T. Improving Students’ Learning With Effective Learning Techniques: Promising Directions From Cognitive and Educational Psychology. Psychological Science in the Public Interest, 2013. DOI: https://doi.org/10.1177/1529100612453266
- KARPICKE, Jeffrey D.; ROEDIGER, Henry L. The Critical Importance of Retrieval for Learning. Science, 2008. DOI: https://doi.org/10.1126/science.1152408
- BJORK, Robert A.; DUNLOSKY, John; KORNELL, Nate. Self-Regulated Learning: Beliefs, Techniques, and Illusions. Annual Review of Psychology, 2013. DOI: https://doi.org/10.1146/annurev-psych-113011-143823
- NATIONAL ACADEMIES OF SCIENCES, ENGINEERING, AND MEDICINE. How People Learn II: Learners, Contexts, and Cultures. Washington, DC: The National Academies Press, 2018. DOI: https://doi.org/10.17226/24783
- ERICSSON, K. Anders. Deliberate Practice and Acquisition of Expert Performance: A General Overview. Academic Emergency Medicine, 2008. DOI: https://doi.org/10.1111/j.1553-2712.2008.00227.x
- MACNAMARA, Brooke N.; MAITRA, Megha. The role of deliberate practice in expert performance: revisiting Ericsson, Krampe & Tesch-Römer (1993). Royal Society Open Science, 2019. DOI: https://doi.org/10.1098/rsos.190327
Formação e mercado de tecnologia
- ACM; IEEE COMPUTER SOCIETY. Computing Curricula 2020 (CC2020): Paradigms for Global Computing Education. 2020. https://www.acm.org/binaries/content/assets/education/curricula-recommendations/cc2020.pdf
- WORLD ECONOMIC FORUM. The Future of Jobs Report 2025. Publicado em 7 jan. 2025. https://www.weforum.org/publications/the-future-of-jobs-report-2025/
- NIST. Workforce Framework for Cybersecurity (NICE Framework), SP 800-181 Rev. 1. https://doi.org/10.6028/NIST.SP.800-181r1
- NIST. NICE Framework Components v2.2.0. Atualização de 28 abr. 2026. https://www.nist.gov/news-events/news/2026/04/nice-releases-nice-framework-components-v220
- ROADMAP.SH. About roadmap.sh. Projeto comunitário de roadmaps e recursos de aprendizagem. https://roadmap.sh/about
IA e aprendizagem de programação
- Less stress, better scores, same learning: The dissociation of performance and learning in AI-supported programming education. Computers and Education: Artificial Intelligence, v. 10, 2026, art. 100537. DOI: https://doi.org/10.1016/j.caeai.2025.100537
- HUANG, Anna Y. Q.; LIN, C.-Y.; SU, S.-Y.; YANG, Stephen J. H. The impact of GenAI-enabled coding hints on students’ programming performance and cognitive load in an SRL-based Python course. British Journal of Educational Technology, 2025. DOI: https://doi.org/10.1111/bjet.13589
Referência prática complementar
- YOUNG, Scott H. Ultralearning: Master Hard Skills, Outsmart the Competition, and Accelerate Your Career. HarperCollins, 2019. O livro é usado aqui como referência prática de estratégias de aprendizagem, não como substituto da literatura experimental citada acima.
FAQ
Preciso aprender fundamentos antes de tocar em ferramentas?
Não todos. O caminho mais produtivo costuma alternar prática e aprofundamento. Comece com uma capacidade concreta, identifique quais fundamentos impedem seu progresso e volte a eles com profundidade suficiente para explicar o comportamento observado.
Roadmap.sh é uma trilha oficial do mercado?
Não. O próprio projeto se apresenta como uma iniciativa comunitária. É útil como mapa de possibilidades e dependências, mas deve ser adaptado ao seu objetivo, experiência e contexto de trabalho.
Assistir cursos é perda de tempo?
Não. Cursos são bons para orientação, sequência e construção do primeiro modelo mental. O problema é parar na exposição. Para consolidar, é necessário recuperar o conteúdo sem pistas, aplicar, receber feedback e revisitar o tema ao longo do tempo.
Como saber se realmente aprendi uma tecnologia?
Tente explicar o modelo sem consultar material, executar uma tarefa nova, diagnosticar uma falha e justificar suas decisões. Se você só reproduz o tutorial original, ainda existe dependência do caminho guiado.
Posso usar IA para estudar sem prejudicar a aprendizagem?
Sim, especialmente quando a IA funciona como tutor, crítico e gerador de feedback. Prefira pedir pistas, perguntas e revisão do seu raciocínio antes de pedir uma solução completa. Performance imediata e aprendizagem durável não são necessariamente a mesma coisa.