Como modelos são treinados, o que bilhões de parâmetros realmente significam, por que “ficar maior” deixou de ser a única resposta e onde a economia da IA pode quebrar antes da tecnologia.
Ideia central: a inteligência artificial não parece ter encontrado um único “teto”. O que está chegando ao limite é uma estratégia mais simples: aumentar parâmetros, dados e
computeesperando que cada nova geração fique proporcionalmente melhor. A nova fronteira combina arquitetura, qualidade de dados, pós-treinamento, inferência, ferramentas, agentes e eficiência econômica.
As quatro perguntas que guiam este artigo
- Como um modelo de linguagem é realmente treinado?
- O que bilhões — ou trilhões — de parâmetros dizem, e o que eles escondem?
- Por que aumentar o tamanho do modelo deixou de ser a única forma de avançar?
- Uma eventual bolha financeira da IA pode estourar sem que a tecnologia desapareça?
Há alguns anos, pedir para uma máquina revisar um contrato, escrever uma função, resumir cem páginas e depois abrir um navegador para executar uma tarefa parecia reunir problemas diferentes demais dentro do mesmo sistema. Em 2026, isso cabe em uma única caixa de texto.
A interface, porém, esconde quase tudo que interessa.
Quando alguém pergunta ao ChatGPT, Claude, Gemini, Grok ou outro assistente “qual é a melhor forma de resolver este problema?”, a resposta parece nascer de uma conversa. Por baixo dela existem tokens, matrizes com bilhões ou trilhões de pesos, clusters de aceleradores, memória de alta largura de banda, camadas de pós-treinamento, filtros, mecanismos de busca, chamadas de ferramentas, caches, sistemas de avaliação e, cada vez mais, loops de agentes capazes de agir em outros sistemas.
É justamente aqui que nasce uma contradição interessante. Nunca tivemos modelos tão capazes, mas nunca se falou tanto em “teto”, falta de dados, custos absurdos, bolha de investimentos e retorno decrescente.
A pergunta correta, portanto, não é simplesmente “a IA parou de evoluir?”. A pergunta é outra: qual parte da estratégia atual começou a chegar ao limite?
O Stanford AI Index de 2026 é explícito ao dizer que a capacidade dos sistemas não está em platô; ao contrário, continua avançando rapidamente. Ao mesmo tempo, a própria indústria passou a depender menos da fórmula simplista “mais parâmetros resolvem tudo”. O centro da corrida migrou para qualidade de dados, arquiteturas esparsas, pós-treinamento, raciocínio em tempo de inferência, multimodalidade, ferramentas e agentes.
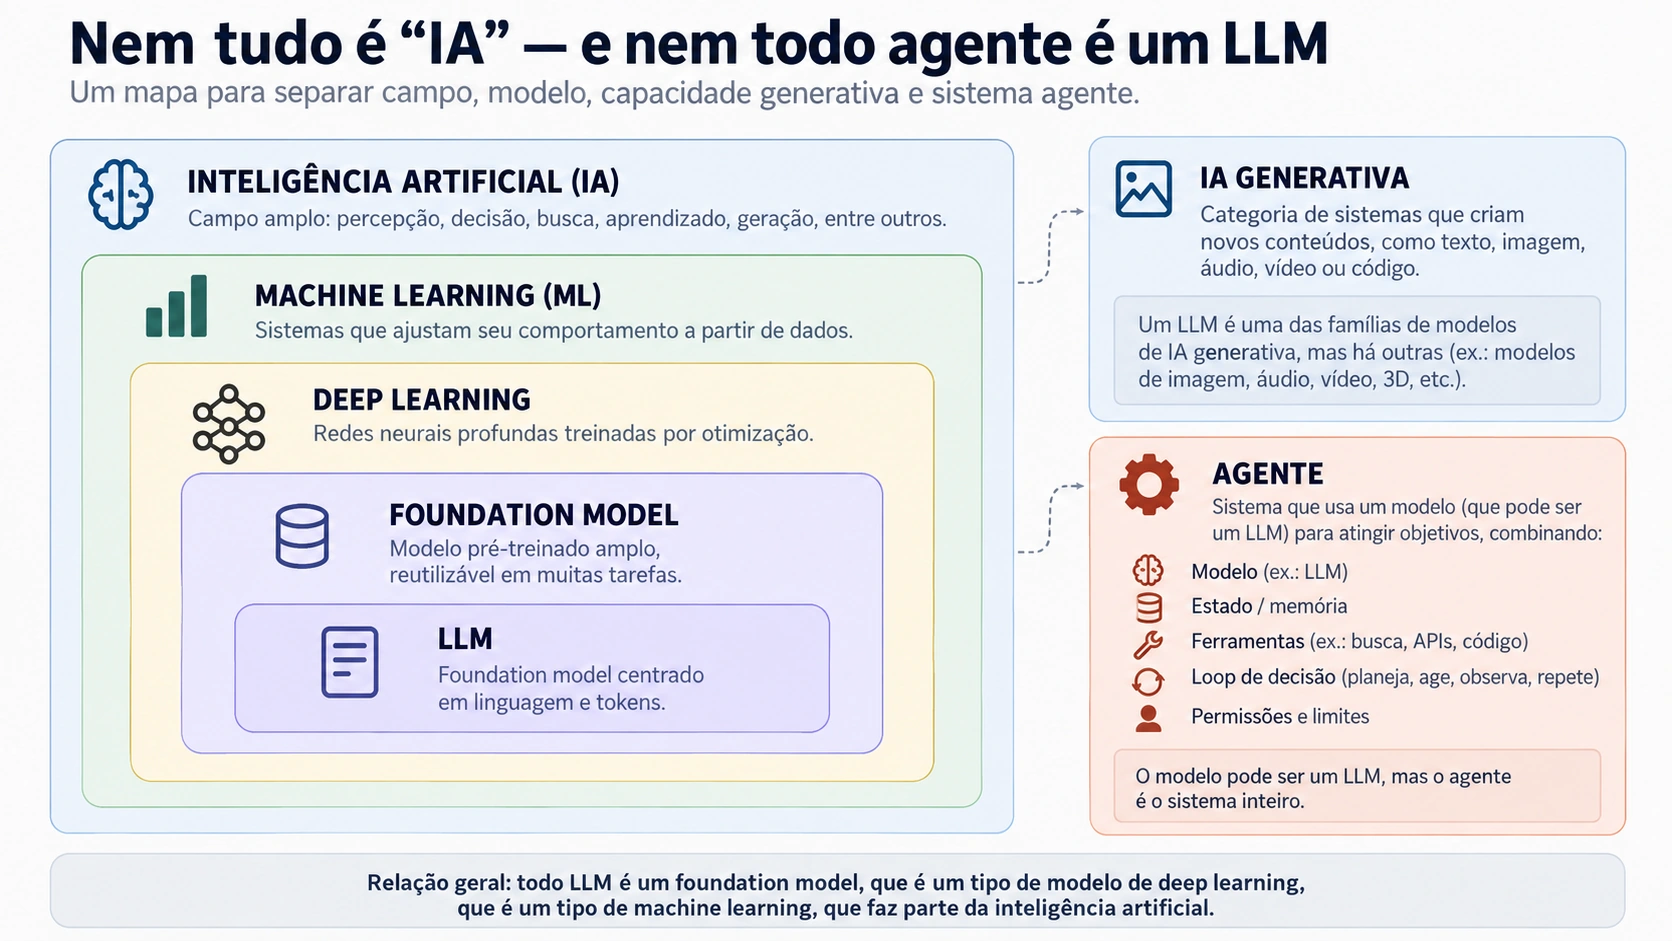
Figura — IA é o campo amplo; LLM, IA generativa e agentes descrevem camadas e capacidades diferentes.
O primeiro erro é chamar tudo de IA
IA é o campo; LLM é apenas uma família
“Inteligência artificial” é o campo amplo. Dentro dele cabem sistemas de busca, classificação, visão computacional, planejamento, recomendação, aprendizado por reforço, redes neurais e modelos generativos. Um LLM é apenas uma família dentro desse universo.
A definição enciclopédica ajuda a organizar o vocabulário: IA generativa é a categoria de sistemas voltados à criação de conteúdo novo a partir de padrões aprendidos. Esse conteúdo pode ser texto, imagem, áudio, vídeo ou código. Um modelo de linguagem de grande escala, por sua vez, é um modelo computacional voltado a tarefas de linguagem, treinado em grandes coleções de dados e, nos sistemas modernos, geralmente construído sobre arquiteturas derivadas do Transformer.
Isso produz uma relação que parece óbvia depois de explicada, mas que é frequentemente invertida:
Mapa mental: pense em IA como o campo; machine learning como uma das abordagens; deep learning como uma família baseada em redes neurais profundas; foundation models como modelos amplos pré-treinados; e LLMs como uma classe de foundation models centrada em linguagem.
| Conceito | O que ele descreve | O que ele não significa |
|---|---|---|
| IA | o campo amplo de métodos e sistemas que executam tarefas associadas a percepção, aprendizado, decisão ou geração | não é sinônimo de chatbot |
| IA generativa | uma categoria de sistemas capazes de gerar novos conteúdos | não precisa ser um LLM; modelos de imagem e áudio também são generativos |
| LLM | um grande modelo voltado principalmente a linguagem e tokens | não é o produto inteiro chamado ChatGPT, Claude ou Gemini |
| Modelo multimodal | um modelo que recebe ou produz mais de uma modalidade, como texto, imagem, áudio ou vídeo | não é automaticamente um agente |
| Agente | um sistema que persegue um objetivo, mantém estado, escolhe ações e usa ferramentas dentro de um loop | não é simplesmente “um LLM mais inteligente” |
Quando o modelo deixa de apenas responder e passa a agir
Esse último ponto é o que mais muda a arquitetura.
Um LLM pode receber a frase “verifique se os servidores estão saudáveis” e devolver um roteiro. Um agente pode receber a mesma meta, consultar o monitoramento, abrir um ticket, executar uma ferramenta autorizada, analisar a saída, decidir se deve continuar e pedir aprovação humana antes de um rollback.
O modelo gera e decide. O agente conecta decisão a ação.
A analogia útil é a de um profissional dentro de uma empresa. O LLM é a pessoa que estudou muito e sabe raciocinar sobre um problema. RAG é dar a ela acesso à documentação interna. Fine-tuning é treiná-la previamente para um tipo particular de comportamento. Memória é o caderno onde ficam fatos da tarefa. Ferramentas são o terminal, o navegador e as APIs. O agente é o profissional inserido num processo com objetivo, credenciais, regras, supervisão e possibilidade de executar trabalho.
Voltando ao conceito técnico: quando um fornecedor vende agentic AI, o que precisa ser avaliado não é apenas o modelo. É o sistema que envolve o modelo.
Ideia-chave: um LLM gera saídas. Um agente organiza decisões e ações ao redor do modelo, usando estado, memória, ferramentas, permissões e um loop de execução.
Um LLM não é o ChatGPT — da mesma forma que um motor não é um carro
Os nomes comerciais confundem porque o usuário conversa com um produto e tende a imaginar que o produto é o modelo.
Produto, modelo e infraestrutura são camadas diferentes
ChatGPT é uma aplicação e um ecossistema. Claude é uma família de produtos e modelos. Gemini é tanto marca de modelos quanto de produtos. Grok também envolve interfaces, modelos e agentes. O modelo é uma peça de uma arquitetura maior.
Uma requisição moderna pode atravessar autenticação, políticas, memória, busca, recuperação de contexto, seleção de modelo, cache, execução do modelo, filtros, ferramentas externas, um verificador e uma camada de apresentação antes de a resposta chegar à tela.
Isso explica por que duas aplicações usando o mesmo modelo podem parecer muito diferentes. Uma pode ter acesso a arquivos, outra não. Uma pode pesquisar a web, outra ficar restrita ao contexto recebido. Uma pode chamar ferramentas, outra apenas gerar texto. Uma pode preservar estado do projeto, outra encerrar tudo no fim da requisição.
Quando a comparação ignora essa camada e olha apenas para “qual modelo responde melhor?”, ela já começa incompleta.
Na prática: comparar apenas o nome do modelo é como comparar dois servidores olhando somente para a CPU. Runtime, memória, rede, cache, ferramentas, políticas e integração também mudam o comportamento percebido.
O modelo não aprende enquanto conversa com você
Esta talvez seja uma das ideias mais importantes para entender por que alguns modelos parecem “parados”.
Contexto muda durante a conversa; os pesos, normalmente, não
Depois do treinamento, o modelo é salvo como um checkpoint: um grande conjunto de parâmetros numéricos. Durante a inferência normal, esses pesos ficam essencialmente congelados. O modelo lê os tokens do contexto, calcula probabilidades e gera novos tokens. A conversa muda o contexto, não os pesos.
Isso significa que um modelo pode usar o que você escreveu dez mensagens atrás porque essa informação está no contexto ou em uma camada externa de memória. Isso não significa que ele tenha sido retreinado em tempo real.
Uma empresa pode posteriormente usar dados autorizados, avaliações, feedback ou novos datasets para treinar outra versão. Mas isso é outro pipeline, com outro checkpoint e novas validações.
Um modelo lançado em janeiro não se torna biologicamente “mais experiente” em setembro. Ele pode receber novos system prompts, ferramentas, RAG, roteadores e interfaces ao redor, mas, se os pesos continuarem iguais, o cérebro estatístico básico continua sendo aquele checkpoint.
Checkpoint é, de forma simplificada, o estado persistido dos parâmetros de um modelo em determinado momento do treinamento. Ele permite carregar, avaliar, continuar treinando ou servir aquela versão do modelo.
Essa é uma das razões pelas quais famílias de modelos desaparecem. Às vezes, não faz sentido continuar refinando uma arquitetura antiga quando outro desenho oferece melhor relação entre qualidade, latência, memória e custo. O modelo não “falhou em evoluir”; o laboratório decidiu deslocar investimento para outro ponto da curva.
Como se treina uma máquina que parece conhecer tanta coisa
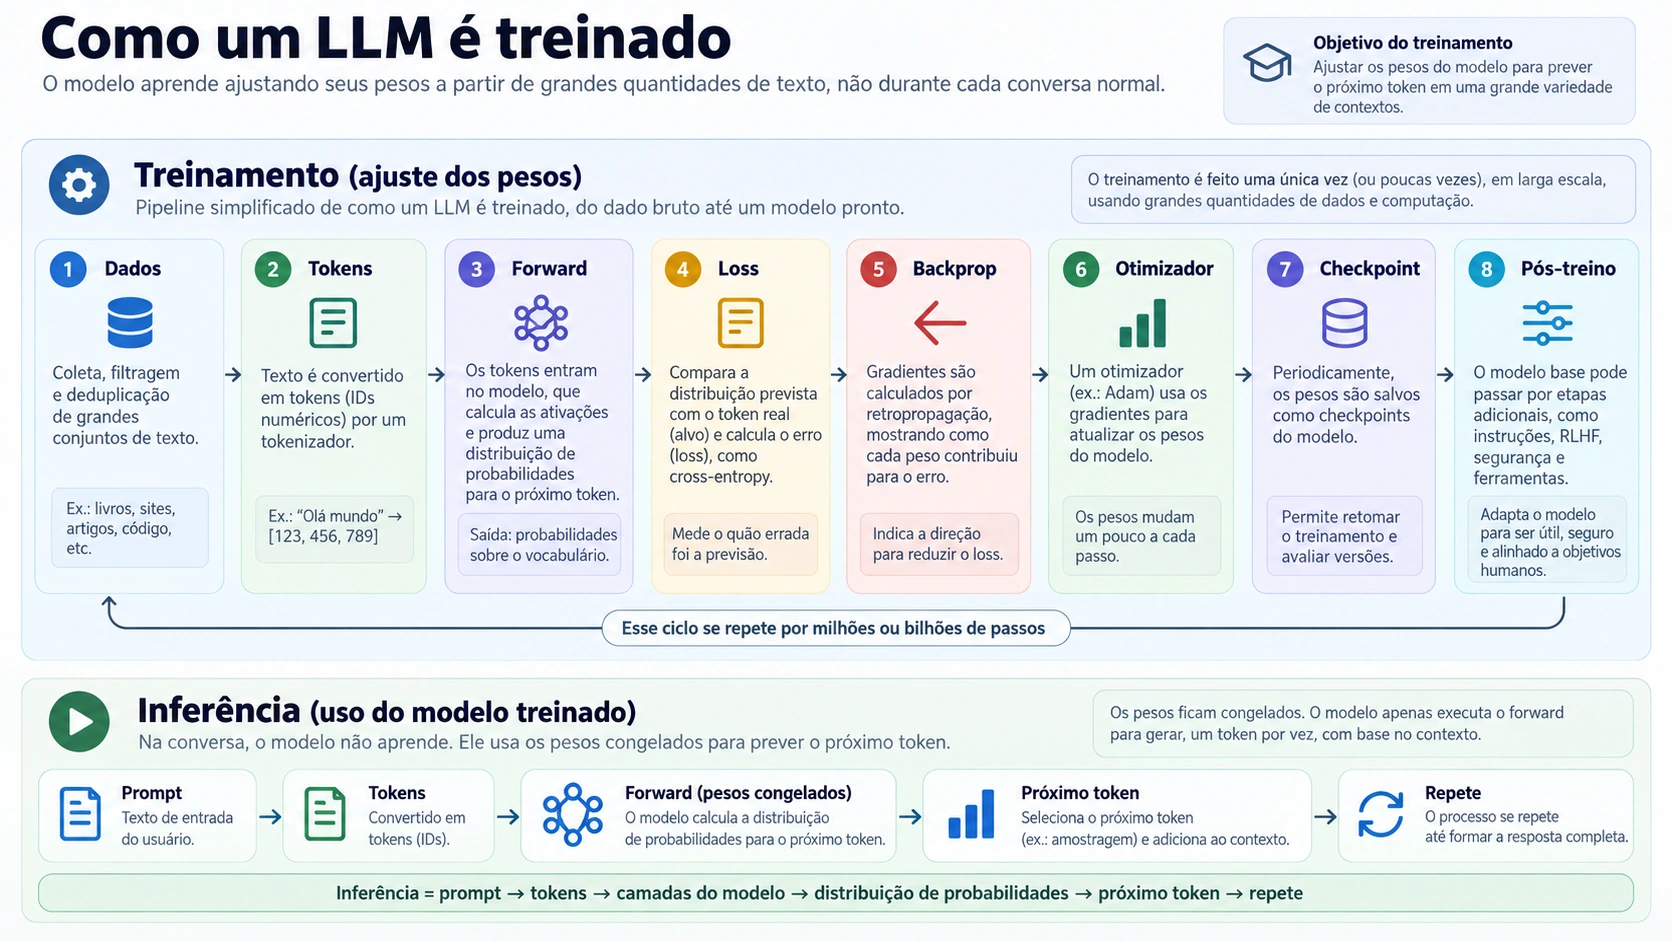
Figura — Do dataset ao checkpoint: treinamento altera os pesos; inferência usa esses pesos para produzir novos tokens.
1. Antes da GPU existe um problema de dados
O treinamento começa muito antes da GPU.
Primeiro vem o dataset. Páginas web, livros licenciados ou permitidos, código, documentos, dados multimodais e coleções especializadas podem passar por filtros de qualidade, deduplicação, remoção de conteúdo indesejado, balanceamento e outras formas de curadoria. O detalhe exato varia por laboratório e, nos modelos fechados, muitas vezes não é público.
2. Texto precisa virar tokens antes de virar cálculo
Depois o texto é quebrado em tokens. Token não é sinônimo de palavra. Dependendo do tokenizer, “computador” pode virar uma unidade ou várias partes. Código, pontuação e espaços também entram nessa representação.
3. O modelo aprende tentando prever o próximo token
Cada token é convertido em vetores numéricos. Esses vetores atravessam as camadas da rede. Em modelos autoregressivos de linguagem, o objetivo básico de pré-treinamento é simples de escrever e gigantesco de executar: dado o contexto anterior, qual é a distribuição de probabilidade do próximo token?
Considere:
“O banco de dados ficou lento porque o índice…”
O modelo não procura uma frase pronta em uma tabela. Ele calcula uma distribuição sobre seu vocabulário. “foi”, “estava”, “não”, “deixou” e milhares de outros tokens recebem probabilidades. Durante o treinamento, a saída prevista é comparada ao token real do exemplo. Essa diferença vira uma função de erro, normalmente associada à cross-entropy.
4. O erro precisa voltar pela rede
Então entra o backpropagation. O sistema calcula como cada peso contribuiu para o erro e produz gradientes. Um otimizador altera os parâmetros em pequenas quantidades. O ciclo se repete em lotes, nós e aceleradores distribuídos, bilhões ou trilhões de vezes.
É como ensinar alguém por meio de uma sequência colossal de exercícios de completar texto, mas com uma diferença decisiva: em vez de guardar explicitamente a resposta de cada exercício, a rede vai ajustando uma estrutura numérica interna capaz de capturar regularidades.
A analogia termina aqui. O modelo não possui “gavetas” onde cada fato ocupa um endereço legível. O conhecimento fica distribuído nos pesos e nas ativações da rede.
5. Pré-treinar não basta para criar um bom assistente
Depois do pré-treinamento vem o pós-treinamento. Entram exemplos de instruções, preferências humanas ou sintéticas, técnicas de otimização por preferência, aprendizado por reforço, treinamento para uso de ferramentas, segurança e formatos específicos de resposta. É nessa fase que um modelo que aprendeu linguagem passa a se comportar como um assistente útil.
O resultado final é um checkpoint. A inferência começa depois.
Resumo da mecânica:
dados → tokens → forward pass → loss → backpropagation → otimização dos pesos → checkpoint → pós-treinamento.
Pré-treino, pós-treino e inferência não são a mesma fase
Pré-treino: adquirir uma representação ampla do mundo textual
A palavra “treinamento” costuma esconder processos diferentes. No pré-treino, o objetivo é fazer o modelo absorver regularidades estatísticas em grande escala: sintaxe, relações semânticas, padrões de código, estruturas de documentos e associações presentes nos dados. É aqui que acontece a parte mais pesada da formação do modelo-base.
Pós-treino: transformar capacidade bruta em comportamento útil
No pós-treino, o problema muda. Já não basta prever texto plausível; o sistema precisa seguir instruções, respeitar formatos, recusar determinadas solicitações, usar ferramentas e produzir respostas que humanos considerem mais úteis. Técnicas como supervised fine-tuning, otimização por preferência e aprendizado por reforço entram justamente porque “saber completar texto” e “se comportar como um assistente” não são a mesma competência.
O trabalho do InstructGPT, publicado em 2022, é uma demonstração histórica dessa diferença. Em avaliações humanas daquele estudo, uma versão de 1,3 bilhão de parâmetros ajustada com feedback humano foi preferida ao GPT-3 de 175 bilhões em várias tarefas de instrução. Não significa que 1,3B seja intelectualmente superior a 175B em qualquer cenário. Significa algo mais importante: escala bruta não substitui alinhamento entre o objetivo de treinamento e o comportamento que o usuário espera.
Inferência: usar o modelo sem refazer o treinamento
Na inferência, por fim, os pesos já treinados são usados para responder. O modelo recebe contexto, executa operações matriciais, produz uma distribuição sobre os próximos tokens e repete o processo. Busca, RAG, memória externa e ferramentas podem mudar radicalmente o que ele consegue fazer sem alterar um único peso.
Essa separação ajuda a entender por que um produto pode melhorar muito entre duas semanas sem que exista um novo pré-treino gigantesco. O laboratório pode trocar o pós-treinamento, o system prompt, o roteador de modelos, o mecanismo de busca, o tool use, o cache ou o agent harness. Para o usuário parece “um modelo novo”; arquiteturalmente, a mudança pode estar em outra camada.
Parâmetros: bilhões de números, não bilhões de neurônios
O que um parâmetro realmente representa
“Este modelo tem 500 bilhões de parâmetros” parece uma medida intuitiva de inteligência. Não é.
Um parâmetro é um valor numérico aprendido que participa das transformações da rede. Matrizes de atenção, projeções e redes feed-forward contêm uma quantidade enorme desses números. Durante o treinamento, eles são ajustados. Durante a inferência, são usados para transformar representações de tokens em novas representações e, por fim, em probabilidades de saída.
Mais parâmetros significam mais capacidade representacional potencial, mas também mais memória, comunicação e computação. Não existe uma regra que diga “duas vezes mais parâmetros = duas vezes mais inteligência”.
A própria história recente demoliu essa equivalência.
Chinchilla mostrou que tamanho sem dados suficientes desperdiça compute
O GPT‑3, de 2020, ficou conhecido por seus 175 bilhões de parâmetros. Em 2022, o trabalho do Chinchilla mostrou que vários modelos grandes estavam subtreinados: havia parâmetros demais para a quantidade de dados usados. O Chinchilla, com 70 bilhões de parâmetros e muito mais tokens de treinamento, superou modelos bem maiores sob orçamento de compute semelhante.
Essa mudança foi fundamental. O problema deixou de ser apenas “quanto cabe no modelo?” e passou a incluir “quanto dado de qualidade esse modelo recebeu e quanto treinamento cada parâmetro realmente aproveitou?”.
Mais tarde, arquiteturas Mixture of Experts tornaram o número ainda mais traiçoeiro.
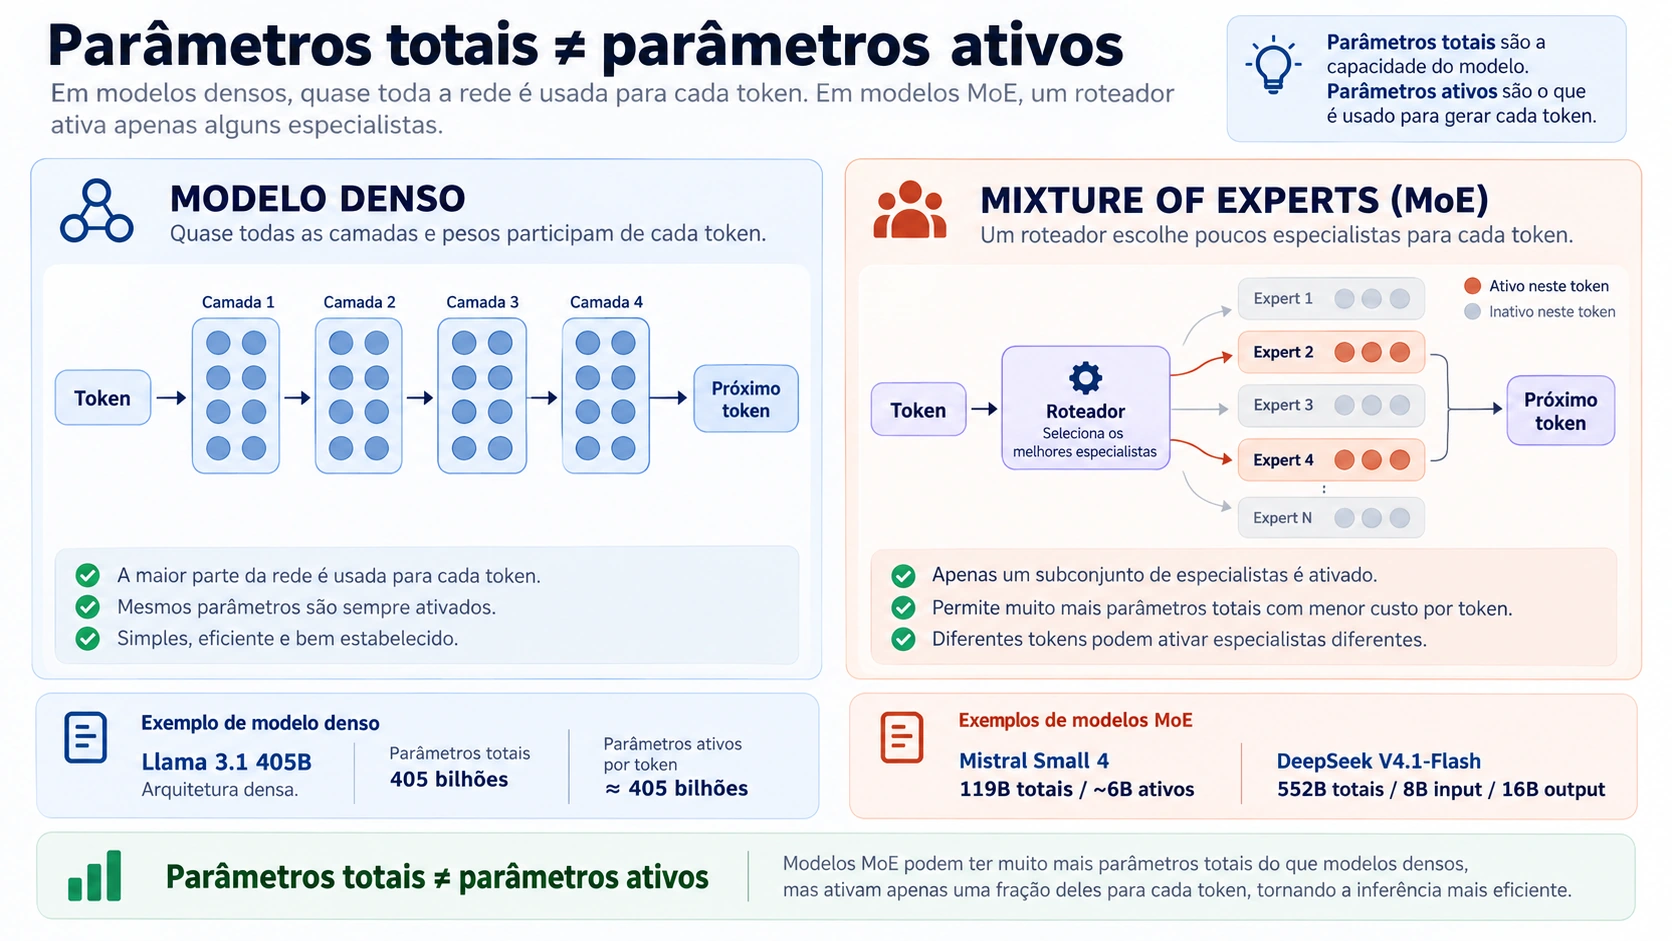
Figura — Em modelos dense, quase toda a rede participa do processamento; em Mixture of Experts, apenas parte dos especialistas é ativada por token.
Quando 2,4 trilhões não significam 2,4 trilhões trabalhando
Parâmetros totais e parâmetros ativos são métricas diferentes
Em uma arquitetura dense, praticamente todas as partes relevantes da rede são usadas para processar cada token. Em um modelo Mixture of Experts — MoE — existem vários blocos especialistas, e um mecanismo de roteamento escolhe apenas alguns deles para cada token.
Imagine um centro técnico com cem especialistas. Um modelo dense chamaria praticamente toda a equipe para discutir cada ticket. Um MoE usa um dispatcher: o ticket de banco de dados vai para alguns especialistas; o de rede, para outros; o de código, para outro grupo.
Voltando à arquitetura, isso permite aumentar a capacidade total sem pagar, em cada token, o custo computacional equivalente a ativar todos os parâmetros.
Os números atuais deixam a diferença clara. O Mistral Small 4, lançado em março de 2026, declara 119 bilhões de parâmetros totais e cerca de 6 bilhões ativos por token. O DeepSeek V4.1‑Flash, de setembro de 2026, declara 552 bilhões de parâmetros em uma arquitetura MoE, mas ativa 8 bilhões na entrada e 16 bilhões na saída. O Qwen3.8‑Max foi anunciado com 2,4 trilhões de parâmetros e arquitetura MoE; a variante open-weight 2.4T‑A95B deixa explícitos aproximadamente 95 bilhões de parâmetros ativos.
Atenção ao número grande: em uma arquitetura
MoE, parâmetros totais descrevem a capacidade armazenada do modelo, enquanto parâmetros ativos ajudam a estimar quanto dessa capacidade participa do processamento de cada token. As duas medidas respondem a perguntas diferentes.
Por isso, uma tabela que ordena modelos apenas por “quantidade de parâmetros” mistura coisas diferentes.
| Modelo documentado | Escala | O que o número ensina |
|---|---|---|
| GPT‑3 (2020) | 175B | marcou a fase em que escala dense virou o principal símbolo de avanço |
| Chinchilla (2022) | 70B | mostrou que melhor equilíbrio entre parâmetros, tokens e compute pode vencer modelos maiores |
| Llama 3.1 405B (2024) | 405B dense | exemplifica o custo e a capacidade de uma arquitetura dense muito grande |
| DeepSeek‑V3 (2024) | 671B total / 37B ativos | mostra como MoE separa capacidade total de custo por token |
| Mistral Small 4 (2026) | 119B total / ~6B ativos | eficiência passa a ser uma variável de projeto explícita |
| DeepSeek V4.1‑Flash (2026) | 552B total / 8B–16B ativos | otimiza também KV cache e cargas agentic, não apenas o total de pesos |
| Qwen3.8 2.4T‑A95B (2026) | 2,4T total / ~95B ativos | “trilhões” deixam de ser uma descrição suficiente do custo real |
Outro detalhe chama atenção: nos modelos de fronteira fechados, a contagem de parâmetros frequentemente nem é mais divulgada. Isso ocorre com os modelos atuais de OpenAI, Anthropic e Google. O Stanford AI Index observa queda na transparência sobre parâmetros, tamanho dos datasets e duração do treinamento entre fornecedores de fronteira.
A consequência editorial é simples: qualquer número de parâmetros atribuído na internet a um modelo fechado deve ser tratado como rumor, a menos que exista documentação do fabricante ou relatório técnico verificável.
O AI Index de 2026 acrescenta uma nuance importante. As contagens reportadas de parâmetros ficaram próximas da casa do trilhão por alguns anos, mas a divulgação caiu justamente entre os laboratórios de fronteira, enquanto estimativas independentes indicam que o training compute continuou crescendo. Portanto, olhar um gráfico público e concluir que “os modelos pararam de crescer” pode confundir duas coisas diferentes: estagnação técnica e desaparecimento da transparência.
Isso também explica por que comparar GPT, Claude e Gemini com modelos open-weight usando apenas parâmetros se tornou metodologicamente fraco. Para vários sistemas fechados, o denominador simplesmente não é conhecido.
A primeira parede: mais parâmetros deixaram de ser a resposta universal
Scaling laws não significam “cresça de qualquer maneira”
O estudo clássico de scaling laws de Kaplan e colaboradores mostrou que perda de linguagem, tamanho do modelo, quantidade de dados e compute seguem relações previsíveis em determinadas faixas. Isso alimentou a ideia de que continuar escalando produziria retornos relativamente regulares.
Mas uma scaling law não diz que qualquer estratégia de aumento de escala é ótima.
O trabalho do Chinchilla expôs justamente isso. Com um orçamento fixo de computação, não adianta colocar quase tudo no tamanho do modelo e economizar nos tokens de treinamento. Parâmetros e dados precisam crescer de forma mais equilibrada.
Esse é o primeiro “teto” real: o teto da alocação ingênua de compute.
A indústria passou a extrair mais de cada unidade computacional usando MoE, melhores datasets, post-training, arquiteturas especializadas, quantização, speculative decoding, cache e otimizações de kernel.
O compute também pode ser gasto depois do treinamento
Ao mesmo tempo, outra fronteira cresceu: gastar mais computação durante a inferência.
Em vez de treinar um modelo 14 vezes maior para todo tipo de pergunta, alguns métodos permitem que um modelo menor gaste mais passos apenas quando o problema exige. Um trabalho de 2024 sobre test-time compute mostrou que, em determinados problemas e sob condições específicas, uma estratégia ótima de computação durante a inferência pode superar um modelo 14 vezes maior.
Consequência prática: a pergunta deixou de ser apenas “quanto
computefoi gasto para treinar?” e passou a incluir “em que fase vale a pena gastarcompute?”
A conclusão não é “modelos pequenos venceram os grandes”. É mais interessante: o local onde gastamos compute passou a ser uma variável de engenharia.
A segunda parede: a internet não é um poço sem fundo
O problema não é “a internet acabar”, e sim o dado útil ficar mais raro
O pré-treinamento moderno consumiu uma parcela imensa do texto publicamente disponível e utilizável. Isso cria um limite que não existia com a mesma intensidade nas primeiras gerações: como continuar aumentando datasets de alta qualidade quando a quantidade de texto humano novo não cresce na mesma velocidade que a demanda computacional?
Um trabalho apresentado na ICML de 2024 estimou, sob suas premissas e tendências observadas, que os datasets de treinamento poderiam se aproximar do estoque disponível de texto público gerado por humanos entre 2026 e 2032. Isso não significa “acabou a internet em 2026”. Significa que duplicar indefinidamente a quantidade de texto humano único, público e apropriado para treinamento deixa de ser uma estratégia garantida.
A saída inclui dados sintéticos, transferência entre domínios, melhor filtragem, multimodalidade e técnicas que usam dados de maneira mais eficiente.
Dados sintéticos ajudam — desde que exista verificação
Mas dados sintéticos criam um problema circular. Se um modelo aprende demais com saídas não verificadas de outros modelos, erros e padrões artificiais podem ser amplificados. A solução não é “gerar infinito”. É gerar, filtrar, verificar e combinar fontes de maneira controlada.
Um artigo publicado na Nature em 2024 mostrou um caso extremo desse risco: modelos treinados recursivamente sobre dados gerados por outros modelos podem perder partes da distribuição original e caminhar para o chamado model collapse. Isso não prova que todo dado sintético seja ruim — datasets sintéticos verificados são hoje uma ferramenta importante de pós-treinamento e raciocínio. O alerta é outro: substituir a diversidade do mundo real por cópias sucessivas da própria distribuição do modelo pode empobrecer o sinal de treinamento.
A mudança parece pequena, mas é conceitual: a corrida deixa de ser apenas pela quantidade de dados e passa a ser pela qualidade do pipeline de dados.
A terceira parede: memória, energia e capital entram na arquitetura
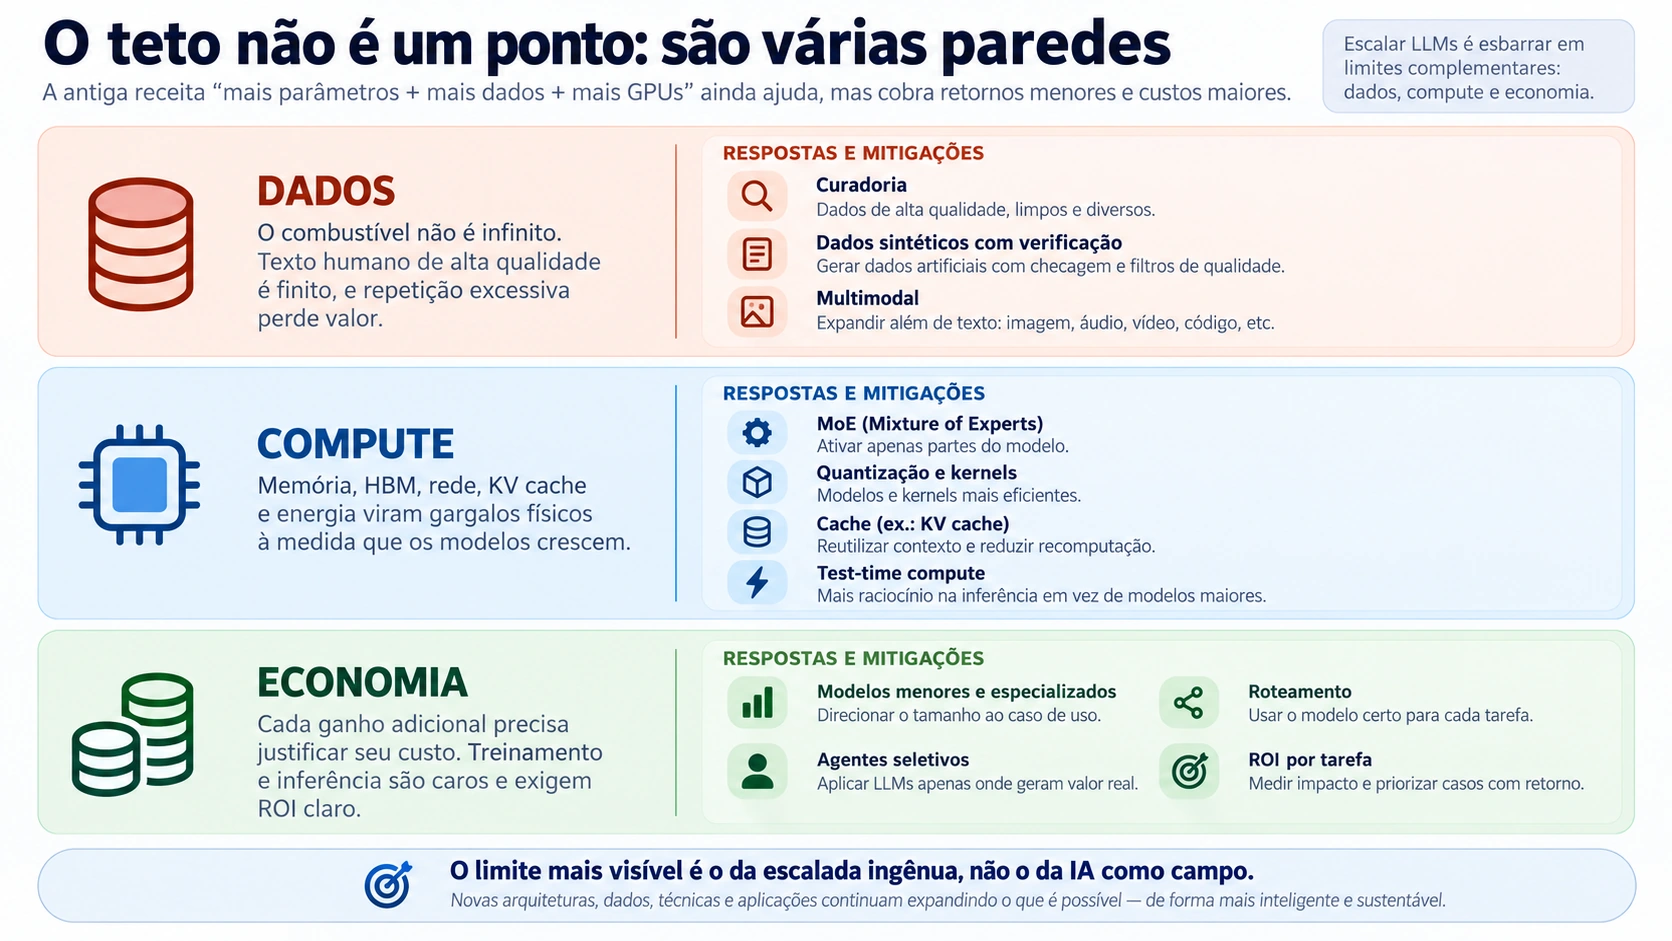
Figura — O scaling encontra gargalos diferentes: disponibilidade de dados, recursos físicos de compute e viabilidade econômica.
Memória e movimentação de dados também são gargalos
Quando um modelo cresce, não aumenta apenas o tempo abstrato de treinamento. Crescem os requisitos de memória, movimentação de dados entre aceleradores, largura de banda, armazenamento, refrigeração e energia.
KV cache: economizar recomputação custa memória
Na inferência de contextos longos, existe ainda o KV cache, uma estrutura usada para evitar recalcular toda a atenção sobre tokens anteriores a cada novo token gerado. Ele acelera a geração, mas ocupa memória. Em agentes que trabalham por muito tempo, reabrem documentos, usam ferramentas e acumulam contexto, esse custo deixa de ser detalhe.
O DeepSeek V4.1‑Flash é um bom exemplo de como a pesquisa atual ataca justamente essa parede: além de reduzir parâmetros ativos, a arquitetura foi desenhada para diminuir fortemente a necessidade de memória e armazenamento do KV cache.
Energia transforma arquitetura em infraestrutura física
No plano físico, a Agência Internacional de Energia projeta que o consumo de eletricidade de data centers possa mais que dobrar até 2030, chegando a cerca de 945 TWh no cenário-base, com IA como um dos principais motores desse crescimento. A própria IEA ressalta a incerteza: eficiência de hardware e software, ritmo de adoção e gargalos energéticos podem alterar bastante a trajetória.
E infraestrutura precisa pagar a própria conta
No plano financeiro, a conta é ainda mais sensível. Data center, GPU, rede e energia são investimentos feitos antes de se conhecer completamente o retorno que as aplicações gerarão.
É aqui que a discussão técnica encontra a discussão sobre bolha.
As soluções atuais não são um novo modelo: são uma pilha
Cada técnica corrige um gargalo diferente
Quando os limites aparecem em pontos diferentes, não existe uma única tecnologia salvadora. A resposta do mercado virou uma composição de técnicas.

Figura — RAG, fine-tuning e agentes não são concorrentes diretos: cada abordagem modifica uma camada diferente do sistema.
| Desafio | Solução típica | O que realmente muda | Limitação |
|---|---|---|---|
| conhecimento privado ou atualizado | RAG / busca | adiciona contexto em tempo de execução | recuperação ruim produz resposta ruim; não muda os pesos |
| comportamento específico de domínio | fine-tuning / pós-treinamento |
altera os pesos para internalizar padrões | exige dataset, avaliação e novo ciclo de treino |
| custo de modelos gigantes | MoE, quantização, roteamento | reduz parâmetros ativos ou precisão numérica | aumenta complexidade de serving e engenharia |
| problemas que exigem mais raciocínio | test-time compute |
gasta mais inferência quando a tarefa precisa | aumenta latência e custo por resposta |
| necessidade de executar trabalho | agentes + ferramentas | conecta o modelo a APIs, navegador, terminal e aplicações | erros deixam de ser apenas texto e podem virar ações |
| contextos longos em agentes | cache, compressão, memória externa | evita carregar ou recalcular tudo a cada passo | memória externa também pode ficar desatualizada ou incorreta |
| confiabilidade | verificadores, testes, aprovações humanas | cria barreiras entre intenção e efeito | adiciona custo e não elimina falhas |
Esse quadro é importante porque desloca a pergunta “qual LLM é melhor?” para “qual arquitetura resolve meu risco, meu custo e meu fluxo?”.
Em uma central de suporte, talvez um modelo menor com RAG e boa busca supere um modelo de fronteira sem acesso à base interna. Em automação de infraestrutura, talvez o melhor modelo seja inútil sem permissões bem desenhadas, dry-run, logs e aprovação para mudanças destrutivas.
O modelo importa. O sistema importa mais do que parecia.
Regra de arquitetura: use RAG quando o problema for contexto externo,
fine-tuningquando for comportamento internalizado e agentes quando o sistema precisar tomar ações. Eles podem coexistir no mesmo produto.
Agente não é chatbot com nome novo
A Wikipédia descreve um agente inteligente como uma entidade que percebe o ambiente, toma ações de forma autônoma para atingir objetivos e pode adaptar seu comportamento. Essa definição é anterior ao hype atual e ajuda a separar o conceito do marketing.
O loop agente: objetivo → ação → observação → nova decisão
Um agente moderno baseado em LLM normalmente executa um loop parecido com este: recebe um objetivo, observa o estado disponível, decide o próximo passo, chama uma ferramenta, lê o resultado, atualiza seu estado e repete até concluir, falhar ou atingir um limite.
Workflow e agente não são sinônimos
A Anthropic faz uma distinção útil entre workflow e agente. Num workflow, o caminho de execução é majoritariamente pré-definido por código: etapa A chama B, que chama C. Num agente, o modelo decide dinamicamente que ferramenta usar, em que ordem e se precisa repetir uma etapa. Quanto mais autonomia passamos para o modelo, maior a flexibilidade — e menor a previsibilidade.
É por isso que adicionar uma chamada de API a um chatbot não o transforma automaticamente em agente. O ponto central é quem controla o fluxo: o código previamente escrito ou o modelo tomando decisões com base no estado do ambiente.
Quando uma alucinação deixa de ser texto e vira efeito no mundo
O salto é grande porque o risco muda de natureza.
Um chatbot que alucina “o servidor está saudável” gera informação errada. Um agente com acesso ao ambiente pode interpretar mal um alerta e executar a ação errada.
Por isso, agentes precisam de controles que raramente aparecem numa demonstração: escopo de credenciais, allowlist de ferramentas, isolamento, validação de parâmetros, timeout, limite de iterações, registro de ações, orçamento, aprovação humana e possibilidade de rollback.
Um agente sem governança é como entregar uma conta administrativa para um estagiário brilhante, rápido e ocasionalmente convicto de coisas falsas.
A analogia serve para visualizar o risco. Tecnicamente, o problema é que modelos probabilísticos agora participam de um pipeline com efeitos de estado. A engenharia precisa assumir que decisões erradas acontecerão e limitar o impacto.
Quem está tentando resolver qual problema em setembro de 2026
Não existe uma única corrida: cada laboratório escolheu uma fronteira
Comparar “as principais IAs” como um ranking único é pouco útil. Cada fornecedor empurra uma parte diferente da fronteira. A tabela abaixo registra o cenário em 14 de setembro de 2026, uma data importante porque os modelos mudam rápido.
| Ecossistema / modelo atual | Ênfase declarada | Desafio que tenta atacar | Trade-off que merece atenção |
|---|---|---|---|
| OpenAI — GPT‑6 Astra | trabalho end-to-end, uso de computador, browsing, coding, pesquisa e ferramentas | transformar raciocínio em execução de tarefas complexas | capacidades maiores exigem controles maiores; parâmetros não são públicos e benchmarks do fornecedor não são comparação neutra |
| Anthropic — Claude Fable 5.1 | coding, knowledge work, pesquisa e projetos longos | confiabilidade em trabalho intelectual e agentic | segurança e governança viram parte do produto; contagem de parâmetros não é pública |
| Google — Gemini 3.8 Flash | raciocínio/coding com foco em velocidade e fluxos agentic | fazer agentes em escala com melhor relação latência/custo | “Flash” prioriza economia operacional; comparação com modelos mais pesados depende da tarefa |
| SpaceXAI/xAI — Grok 4.6 | agentes de longa duração e trabalho interativo/visual | manter tarefas por muitos passos e conectar o modelo ao ambiente | autonomia prolongada aumenta custo de observabilidade, permissões e controle |
| Meta — Muse Spark 1.3 | coding e tarefas agentic de longo horizonte, uso de ferramentas e colaboração em fluxos extensos | reduzir desperdício de tool calls e sustentar múltiplos workstreams no mesmo contexto | benchmarks e ganhos de eficiência do lançamento são majoritariamente divulgados pela própria Meta; open weights do Spark ainda estavam no roadmap em 14/09/2026 |
| DeepSeek — V4.1‑Flash | MoE, baixa ativação e KV cache reduzido | reduzir custo de workloads longos e agentic sem depender apenas de modelo menor | arquitetura eficiente é mais complexa de servir e otimizar |
| Alibaba — Qwen3.8‑Max / 2.4T‑A95B | escala MoE, multimodalidade, longo contexto e open weights | combinar grande capacidade total com ativação esparsa | 2,4T de pesos ainda são pesados para hospedar; open weights não significa infraestrutura barata |
| Mistral — Small 4 / Medium 3.5 | eficiência, open weights e implantação controlável | entregar raciocínio, multimodalidade e agentes com menos parâmetros ativos | pode ser preferível em soberania/on-prem mesmo quando outro modelo vence um benchmark específico |
Esse quadro mostra a transformação do mercado. Em 2023 a conversa girava fortemente em torno de “qual chatbot escreve melhor?”. Em 2026, os anúncios destacam computer use, agentes, uso de ferramentas, contextos longos, custo de inferência, reasoning effort e arquitetura de cache.
Mudança de eixo: a competição de 2026 não acontece apenas em qualidade textual. Ela envolve *
computer use*, uso de ferramentas, agentes, latência, custo de inferência, contexto, multimodalidade e confiabilidade.
A fronteira saiu da caixa de texto.
Também é por isso que benchmarks precisam ser tratados com cuidado. Um fornecedor pode testar com tool use, outro sem; um pode gastar mais tokens de raciocínio; outro pode usar múltiplas tentativas. O Stanford AI Index de 2026 observa que modelos de ponta estão cada vez mais próximos em algumas avaliações, deslocando a competição para custo, confiabilidade e desempenho específico de domínio.
O próprio AI Index mostra outro problema: capacidade e benchmark estão correndo em velocidades diferentes. Em algumas avaliações recentes, modelos ganharam dezenas de pontos em um ano, e testes criados para durar anos saturaram em meses. Quando isso acontece, melhorar no benchmark deixa de separar adequadamente os melhores sistemas. A indústria então migra para tarefas mais longas, ambientes interativos, coding real, computer use e avaliações de agentes — justamente onde medir sucesso é mais caro e reproduzir o experimento é mais difícil.
Esse detalhe é importante para qualquer ranking de “melhores IAs”. Uma posição absoluta sem contexto de custo, configuração de raciocínio, ferramentas permitidas e metodologia pode dizer menos do que parece.
Por que alguns modelos parecem não evoluir mais
“Estagnação” pode significar três coisas diferentes
Existem pelo menos três fenômenos que as pessoas costumam juntar sob a palavra “estagnação”.
O primeiro é o checkpoint congelado. Um modelo lançado não acumula aprendizado apenas por estar atendendo milhões de usuários. Para melhorar os pesos, é necessário novo treinamento ou pós-treinamento.
O segundo é o retorno marginal. Uma arquitetura pode continuar melhorando, mas cada ponto adicional custa muito mais. Se outra arquitetura entrega resultado semelhante ativando uma fração dos parâmetros, a empresa pode abandonar a linhagem antiga.
O terceiro é mudança de eixo. Uma empresa pode parar de aumentar parâmetros e investir em agentes, multimodalidade, test-time compute, ferramentas ou integração. Vista de fora, a família de modelos “parou”. Por dentro, o orçamento de pesquisa mudou de direção.
A Meta é um exemplo útil. A empresa continua mantendo o ecossistema Llama, mas em 2026 passou a empurrar a linha Muse Spark como frente de produto para coding e workloads agentic. O Muse Spark 1.3, lançado em 2 de setembro, foi descrito pela empresa como uma atualização voltada a trabalho de longo horizonte, geração dinâmica de contexto, correção de lacunas no plano e redução de chamadas de ferramenta e tokens em relação ao 1.2. Isso não prova que “Llama chegou ao limite”. Mostra que a vantagem competitiva deixou de depender apenas de produzir um checkpoint maior da mesma família.
O DeepSeek oferece outro sinal: o V4.1‑Flash foi apresentado como modelo menor da nova arquitetura e, mesmo assim, a empresa afirma que ele supera seu V4‑Pro anterior em avaliações próprias. O objetivo declarado não é vencer pela quantidade bruta de parâmetros, mas por arquitetura, pré-treinamento, pós-treinamento e eficiência de cache.
O ponto central: uma família de modelos pode deixar de crescer porque o laboratório mudou a arquitetura, o orçamento de pesquisa ou a camada onde busca ganho. Isso é diferente de provar que a IA atingiu um limite definitivo.
A lição é incômoda para rankings: progresso de IA não é uma linha onde todo modelo precisa apenas ficar maior que o anterior.
Então chegamos ao limite?
Depende de qual limite estamos discutindo
Se “limite” significa “os modelos pararam de melhorar”, os dados atuais não sustentam essa conclusão. O Stanford AI Index de 2026 afirma justamente o contrário e mostra avanço rápido em benchmarks difíceis e sistemas agentic.
Se “limite” significa “a velha receita de aumentar um modelo dense, despejar mais texto da internet e assumir que o resto escala sozinho perdeu eficiência”, então sim: há sinais claros de que essa fase mudou.
Existem limites de dados. Existem limites de memória e energia. Existem limites econômicos. Existem benchmarks que saturam rápido demais. Existem tarefas em que mais test-time compute é mais eficiente do que outro salto de parâmetros. Existem situações em que ferramentas resolvem um problema que o pré-treinamento não deveria tentar memorizar.
Esse conjunto não forma uma parede final. Forma uma mudança de engenharia.
Quatro paredes que explicam melhor o problema
Há, na prática, pelo menos quatro paredes diferentes:
- Parede estatística: aumentar parâmetros sem aumentar dados e treinamento adequadamente desperdiça capacidade.
- Parede de dados: texto humano público, único e de alta qualidade não cresce na mesma velocidade do apetite dos treinamentos.
- Parede física: HBM, interconexão, energia, refrigeração, armazenamento e
KV cacheimpõem custos que o software não consegue fingir que não existem. - Parede econômica: um ganho de benchmark só tem valor industrial se o custo de treinamento e inferência puder ser convertido em receita, produtividade, redução de risco ou outra vantagem mensurável.
A chamada “chegada ao limite” é, portanto, menos parecida com bater numa parede e mais parecida com perceber que a estrada reta acabou. O progresso continua, mas exige curvas arquiteturais.
Síntese: o “teto” mais visível é o da escalada ingênua, não necessariamente o da capacidade da IA como campo.
O que chamávamos de “modelo” está virando apenas um componente de uma pilha maior.
A IA é uma bolha que pode estourar?
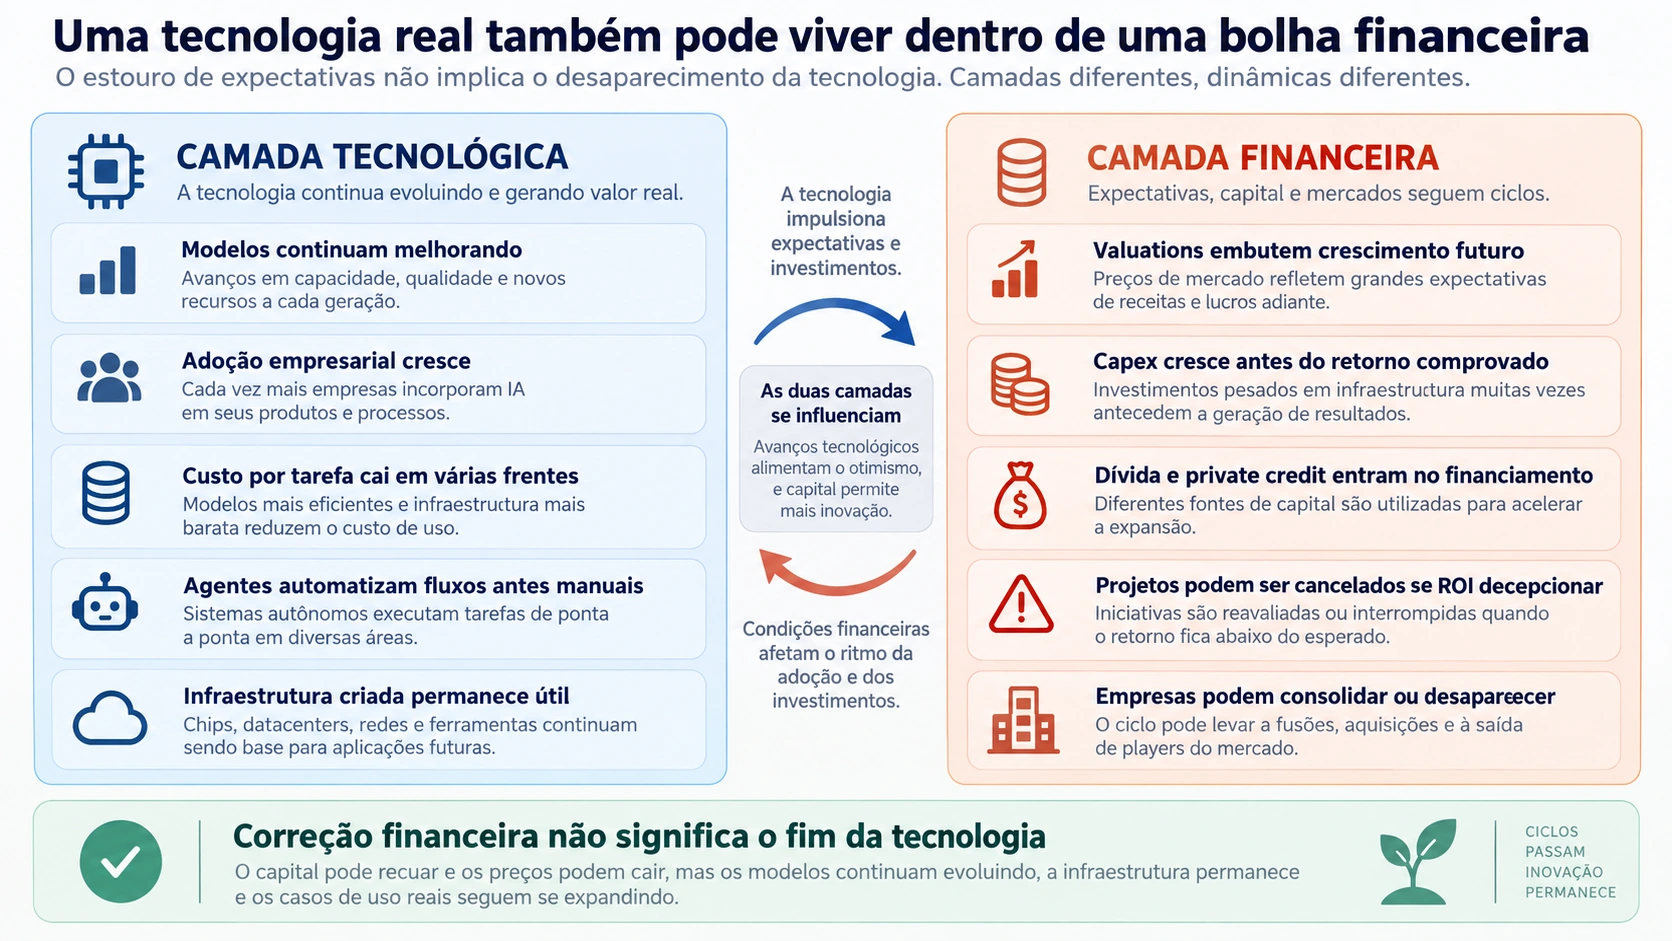
Figura — A camada tecnológica e a camada financeira se influenciam, mas não são a mesma coisa.
Tecnologia útil e excesso financeiro podem coexistir
Uma tecnologia pode funcionar e, ao mesmo tempo, receber capital demais.
Essa distinção evita dois erros opostos. O primeiro é acreditar que, como os modelos são úteis, qualquer valuation ou investimento em data center faz sentido. O segundo é imaginar que uma correção financeira provaria que “IA nunca funcionou”.
O BIS, Banco de Compensações Internacionais, chamou atenção em setembro de 2026 para a escala do boom de investimento. O órgão descreve valuations elevados e concentrados, capex crescendo mais rápido que fluxos de caixa em grandes empresas, aumento de financiamento por dívida e private credit e estruturas de financiamento interconectadas. Sua preocupação é condicional: se os retornos da IA decepcionarem, a expansão atual pode se transformar em retração.
Isso não é previsão de um crash em uma data específica. O próprio BIS ressalta que esse resultado não é inevitável.
O outro lado: existe adoção real
Ao mesmo tempo, o Stanford AI Index registra forte crescimento de adoção, investimento e uso empresarial. Ou seja: há demanda real.
A história oferece paralelos úteis, mas deve ser usada com cuidado. Ferrovias, eletrificação e internet foram tecnologias transformadoras que também viveram ciclos de investimento excessivo. A correção destruiu empresas e capital, não os trilhos, a eletricidade ou o protocolo TCP/IP.
Leitura do artigo: a hipótese mais plausível não é “a IA deixa de existir”, mas o capital ficar mais seletivo e exigir retorno mensurável.
Minha leitura para a IA é semelhante: a bolha mais plausível está nas expectativas financeiras e na velocidade do capex, não na existência da tecnologia.
Se houver correção, ela tende a separar utilidade de expectativa
Se houver um “estouro”, ele provavelmente será seletivo. Startups sem diferenciação podem desaparecer. Projetos de data center com retorno fraco podem ser adiados. Modelos muito caros podem sofrer pressão de alternativas open-weight ou mais eficientes. Margens podem cair. Fornecedores podem consolidar.
Mas servidores, GPUs, redes, datasets curados, integrações e processos automatizados não evaporam. Parte da infraestrutura superdimensionada de um ciclo especulativo pode, depois da correção, tornar a próxima fase mais barata.
O ponto mais difícil é o timing. Ninguém possui um indicador confiável capaz de dizer “a bolha estoura no trimestre X”. Quem afirma isso está fazendo uma aposta, não descrevendo um fato técnico.
O prognóstico mais interessante não é um modelo maior
A métrica mais útil tende a migrar de “tamanho” para “resultado por custo”
Entre 2026 e 2030, a métrica “quantos parâmetros?” tende a perder valor como atalho de capacidade. Ela continuará útil para arquitetura e infraestrutura, mas menos útil como slogan.
O número que importa mais em produção será algo como: quanto custa completar uma tarefa com qualidade aceitável e risco controlado?
Um sistema poderá usar modelos diferentes para tarefas diferentes
Isso empurra o mercado para modelos especializados e roteamento dinâmico. Um sistema poderá usar um modelo barato para classificar tickets, um modelo mais forte para raciocínio complexo e um agente com ferramentas apenas quando a tarefa realmente exigir ação.
Contexto proprietário pode valer mais que o modelo isolado
Também é provável que o valor econômico se desloque do modelo isolado para o contexto proprietário e a integração. Uma empresa não precisa treinar o maior LLM do mundo para obter vantagem. Pode precisar de um bom modelo conectado aos seus contratos, inventário, documentação, telemetria, código, políticas e processos.
Quanto mais autonomia, mais segurança precisa virar arquitetura
Agentes devem aumentar esse valor e também o risco. Quando a IA apenas escreve texto, um erro pode ser revisado. Quando ela fecha uma compra, altera uma política, executa código ou mexe em produção, segurança passa a ser arquitetura, não rodapé.
Outro prognóstico é que a fronteira entre treinamento e inferência ficará menos rígida do ponto de vista do orçamento. Nem todo ganho virá de meses de pré-treinamento; parte virá de permitir que o sistema pense, pesquise, simule, verifique e tente novamente durante a execução.
E existe uma consequência econômica: quanto mais modelos se aproximam em qualidade geral, mais a competição muda para preço, latência, disponibilidade, privacidade, governança, integração e custo total de operação.
Isso é um sinal de maturidade — e também de compressão de margens.
O que muda para quem trabalha com TI
Prompt é só a superfície operacional
O profissional que entende apenas prompt vê uma caixa de texto. O profissional que entende a pilha vê decisões arquiteturais.
Uma resposta lenta pode ser modelo demais para uma tarefa simples, contexto excessivo ou cache ineficiente. Uma alucinação pode ser falta de fonte, recuperação ruim ou instrução ambígua. Um agente que falhou pode ter escolhido a ferramenta errada, interpretado mal o retorno, perdido estado ou recebido permissões demais. Um custo alto pode vir de tokens de saída, de contextos reprocessados ou de loops longos.
Troubleshooting de IA se aproxima de engenharia distribuída
A depuração de sistemas com IA começa a se parecer menos com “conversar melhor” e mais com engenharia distribuída: logs, métricas, tracing, avaliação, timeouts, retries, idempotência, isolamento, controle de acesso e observabilidade.
Em outras palavras, quanto mais a IA parece mágica na interface, mais tradicional fica a responsabilidade de quem precisa colocá-la em produção.
O teto que encontramos era o teto da abstração
Quando abrimos a caixa, a “mágica” vira arquitetura
No início deste artigo, a caixa de texto parecia esconder uma máquina que simplesmente “sabia”.
Agora ela parece outra coisa: um modelo probabilístico treinado em escala, cercado por dados, caches, ferramentas, memória, políticas, redes, data centers e capital.
Isso muda a pergunta sobre o futuro.
A IA não parece ter encontrado um único muro final. Encontrou vários gargalos que tornam o caminho antigo mais caro: dados humanos finitos, infraestrutura física, energia, memória, avaliações saturadas, riscos agentic e expectativa financeira.
A resposta da indústria já está visível: menos obsessão com o número bruto de parâmetros e mais arquitetura; menos modelo isolado e mais sistema; menos resposta única e mais verificação; menos chatbot e mais agente; menos “quanto ele sabe?” e mais “o que ele consegue concluir, a que custo e com quais garantias?”.
A possível bolha não invalida isso. Uma correção pode derrubar valuations, fornecedores e projetos que não justificarem o capital investido. Mas a tecnologia que resolve problemas reais tende a permanecer — talvez mais barata, menos glamourosa e muito mais integrada ao restante da infraestrutura.
O próximo salto pode não parecer um cérebro digital maior.
Pode parecer apenas um sistema melhor projetado.
Glossário essencial para acompanhar o artigo
| Termo | Significado neste artigo |
|---|---|
| LLM | Large Language Model: modelo de linguagem treinado em grande escala para processar e gerar sequências de tokens. |
| Token | unidade numérica usada pelo modelo para representar partes de texto, código e outros símbolos. |
| Parâmetro / peso | valor numérico aprendido durante o treinamento e usado nas transformações internas da rede. |
| Checkpoint | estado persistido dos parâmetros do modelo em determinado ponto do treinamento. |
| Inferência | fase em que o modelo já treinado recebe contexto e produz uma saída. |
| Pré-treinamento | etapa de treinamento em grande escala que constrói as capacidades gerais do modelo-base. |
| Pós-treinamento | conjunto de técnicas que adapta o modelo para seguir instruções, preferências, políticas e uso de ferramentas. |
| RAG | Retrieval-Augmented Generation: recuperação de informação externa para enriquecer o contexto enviado ao modelo. |
| Fine-tuning | treinamento adicional que altera os pesos para adaptar comportamento ou domínio. |
| MoE | Mixture of Experts: arquitetura em que um roteador ativa apenas parte dos blocos especialistas para cada token. |
| KV cache | memória usada na inferência para reutilizar estados de atenção e evitar recomputações desnecessárias. |
| Test-time compute | computação adicional gasta durante a inferência para permitir mais passos de raciocínio ou verificação. |
| Agente | sistema orientado a objetivos que combina modelo, estado, ferramentas, decisões e regras de execução. |
| CapEx | investimento em ativos e infraestrutura, como data centers, aceleradores, rede e energia. |
| ROI | retorno sobre o investimento; relação entre o valor gerado por uma iniciativa e o custo necessário para mantê-la. |
FAQ
LLM e IA generativa são a mesma coisa?
Não. LLM é uma família de modelos voltada principalmente à linguagem. IA generativa é uma categoria mais ampla que inclui geração de texto, imagem, áudio, vídeo, código e outras modalidades.
Um agente é um LLM?
Não necessariamente. Um agente é um sistema orientado a objetivos que observa estado, decide e executa ações. Um LLM pode ser o mecanismo central de decisão, mas ferramentas, memória, permissões e loop de execução fazem parte do agente.
Mais parâmetros significam um modelo melhor?
Não de forma automática. Parâmetros aumentam capacidade, mas o resultado depende de dados, compute, arquitetura, pós-treinamento, parâmetros ativos, avaliação e custo de inferência. Chinchilla é o exemplo clássico de modelo menor que superou modelos maiores graças a uma melhor relação entre escala e dados.
O modelo aprende com cada conversa?
Na inferência normal, não. A conversa altera o contexto disponível para a resposta. Os pesos do modelo permanecem congelados até que exista um novo processo de treinamento ou pós-treinamento.
RAG é treinamento?
Não. RAG recupera informações externas e as adiciona ao contexto durante a execução. Fine-tuning altera pesos; RAG não.
A bolha de IA pode estourar?
Pode haver correção financeira, mas não existe base séria para marcar uma data. O risco cresce quando expectativas de lucro, valuations e investimento em infraestrutura correm mais rápido que a monetização. Uma correção financeira também não implica que a tecnologia deixe de ser útil.
Referências e fontes
Critério de fontes: documentação oficial e literatura acadêmica sustentam as afirmações centrais; Wikipédia entra como apoio terminológico e de navegação conceitual.
A Wikipédia foi usada apenas como fonte secundária para terminologia, histórico e navegação conceitual. Afirmações técnicas e econômicas centrais foram verificadas preferencialmente em papers revisados/publicados, documentação oficial dos laboratórios, Stanford HAI, IEA e BIS. Benchmarks divulgados por fabricantes são tratados como resultados do próprio fornecedor, não como medições independentes.
- Vaswani et al. Attention Is All You Need. NeurIPS, 2017.
Acessar fonte - Kaplan et al. Scaling Laws for Neural Language Models. 2020.
Acessar fonte - Hoffmann et al. Training Compute-Optimal Large Language Models (Chinchilla). 2022.
Acessar fonte - Villalobos et al. Will We Run Out of Data? Limits of LLM Scaling Based on Human-Generated Data. ICML, 2024.
Acessar fonte - Snell et al. Scaling LLM Test-Time Compute Optimally can be More Effective than Scaling Model Parameters. 2024.
Acessar fonte - Meta. The Llama 3 Herd of Models. 2024.
Acessar fonte - DeepSeek-AI. DeepSeek-V3 Technical Report.
Acessar fonte - Stanford HAI. 2026 AI Index Report.
Acessar fonte - International Energy Agency. Energy and AI — Executive summary.
Acessar fonte - Bank for International Settlements. Artificial intelligence, growth and financial stability: challenges for central banks. 10 set. 2026.
Acessar fonte - OpenAI. GPT‑6 Astra: A new generation of intelligence. 3 set. 2026.
Acessar fonte - Anthropic. Claude Fable 5.1 and Claude Mythos 5.1. set. 2026.
Acessar fonte - Google. Introducing Gemini 3.8 Flash and 3.8 Flash Cyber. 2 set. 2026.
Acessar fonte - SpaceXAI/xAI. Introducing Grok 4.6. 12 ago. 2026.
Acessar fonte - Meta. Introducing Muse Spark 1.3. 2 set. 2026.
Acessar fonte - DeepSeek. Introducing DeepSeek-V4.1-Flash. 10 set. 2026.
Acessar fonte - Alibaba Cloud. Alibaba Unveils Qwen3.8-Max. 3 ago. 2026.
Acessar fonte - Mistral AI. Introducing Mistral Small 4. 16 mar. 2026.
Acessar fonte - Ouyang et al. Training language models to follow instructions with human feedback. 2022.
Acessar fonte - Lewis et al. Retrieval-Augmented Generation for Knowledge-Intensive NLP Tasks. 2020.
Acessar fonte - Fedus, Zoph & Shazeer. Switch Transformers: Scaling to Trillion Parameter Models with Simple and Efficient Sparsity. JMLR, 2022.
Acessar fonte - Shumailov et al. AI models collapse when trained on recursively generated data. Nature, 2024.
Acessar fonte - Anthropic. Building Effective AI Agents. 2024.
Acessar fonte - Wikipédia. Generative artificial intelligence.
Acessar fonte - Wikipédia. Large language model.
Acessar fonte - Wikipédia. Intelligent agent.
Acessar fonte - Wikipédia. Transformer (deep learning architecture).
Acessar fonte